CASE STUDY · EY
Data Fusion & KMS
Design af brugerfladen til EY's AI-drevne dataplatform for finansielle institutioner, og de nye apps, der bygges oven på den.
- Min rolle
- Lead UX/UI Designer
- Virksomhed
- EY
- Designede skærme
- 100+
- Værktøjer
- Figma, Miro, Motif (EY's designsystem)
- Metode
- Scrum, Azure DevOps
- 150+kunder i produktion
- 9.000+datakilder
- 6.000+forretningsregler
- Op til 50%hurtigere udvikling af pipelines
Offentlige tal fra EY's officielle præsentation af platformen.
01 · PLATFORMEN
Se den i brug
Dette er EY's officielle præsentation af Data Fusion. Den gennemgår platformens vigtigste moduler: dataforberedelse, governance, datakvalitet, dataopdagelse og drift.
02 · KONTEKST
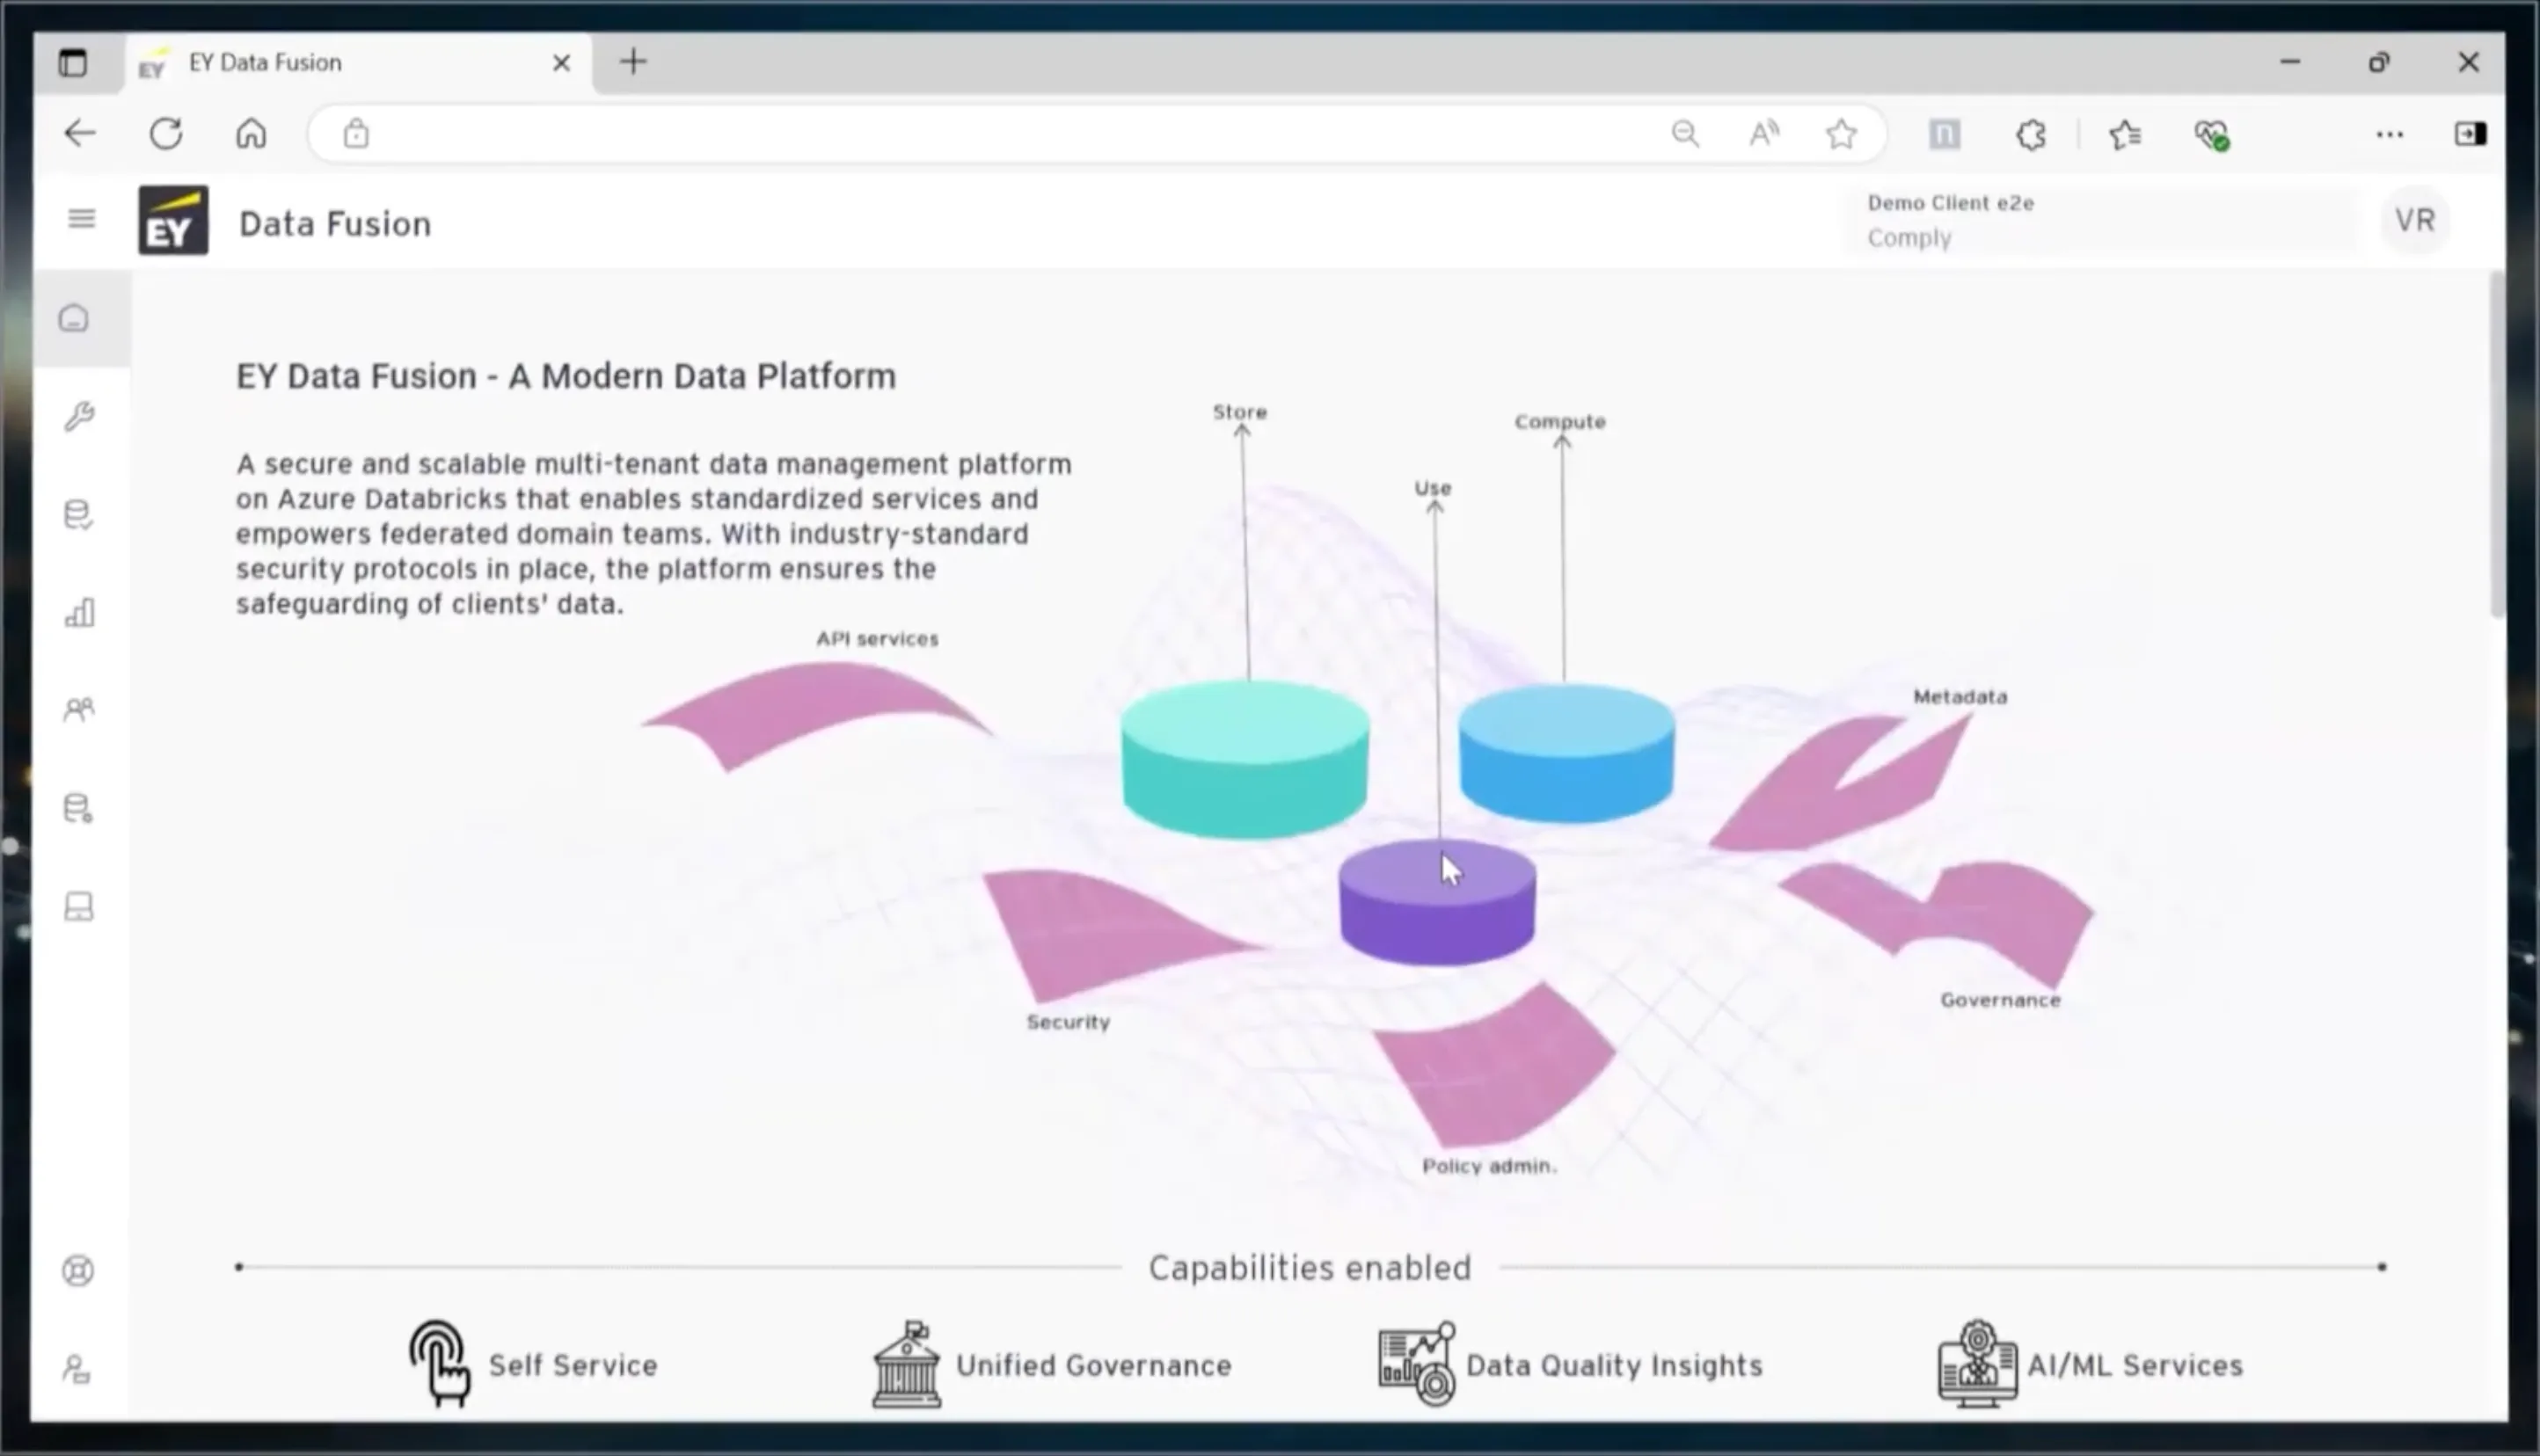
Hvad er Data Fusion?
Kort fortalt
Banker og finansielle institutioner modtager data fra tusindvis af steder: interne systemer, filer, partnere. Før de data kan bruges med tillid til rapporter, beslutninger eller AI, skal nogen hente dem ind, rense dem, tjekke dem mod forretningsreglerne og organisere dem. Data Fusion er platformen, hvor alt det sker.
Det er en cloudbaseret, AI-drevet multi-tenant-platform bygget på Databricks. Én platform betjener mange kunder, hver i sit eget isolerede rum, og en low-code / no-code-brugerflade lader forretnings- og tekniske teams arbejde med data uden at skrive kode.
Hvad platformen gør
- 01
Data Preparation
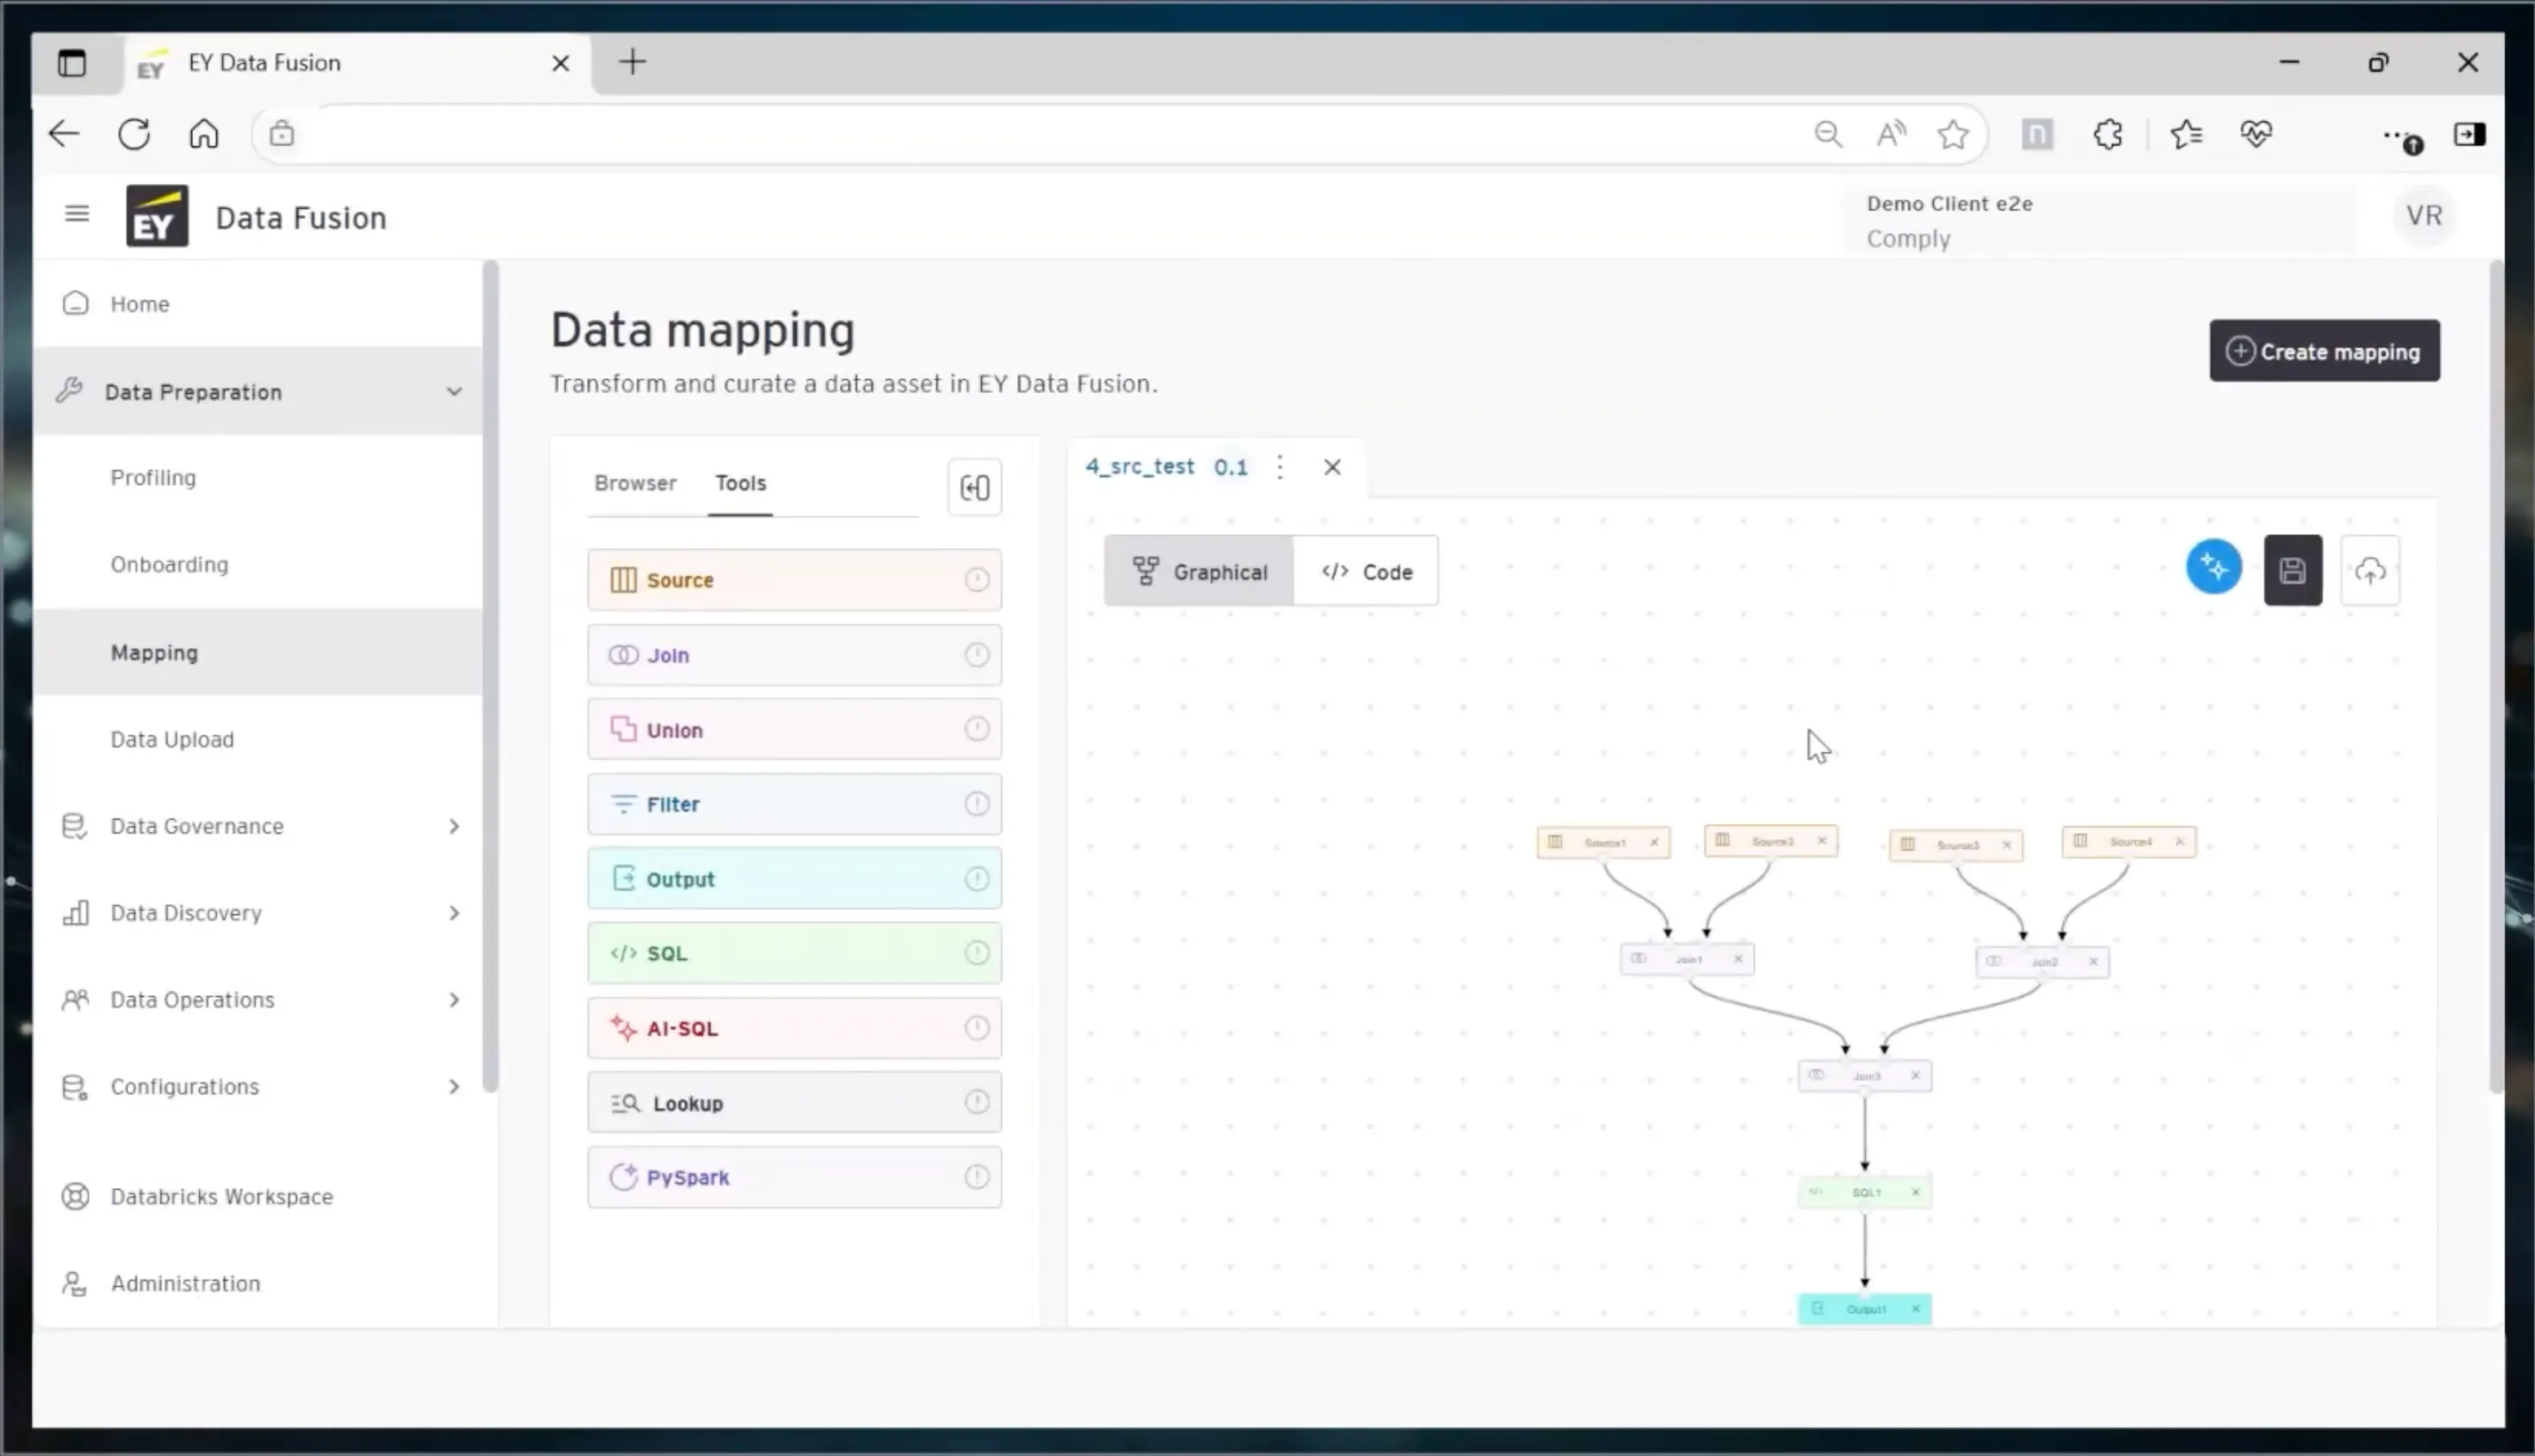
Upload filer, analyser dem for mønstre og anomalier, tilføj nye datakilder og map rå data til kuraterede datasæt.
- 02
Data Governance
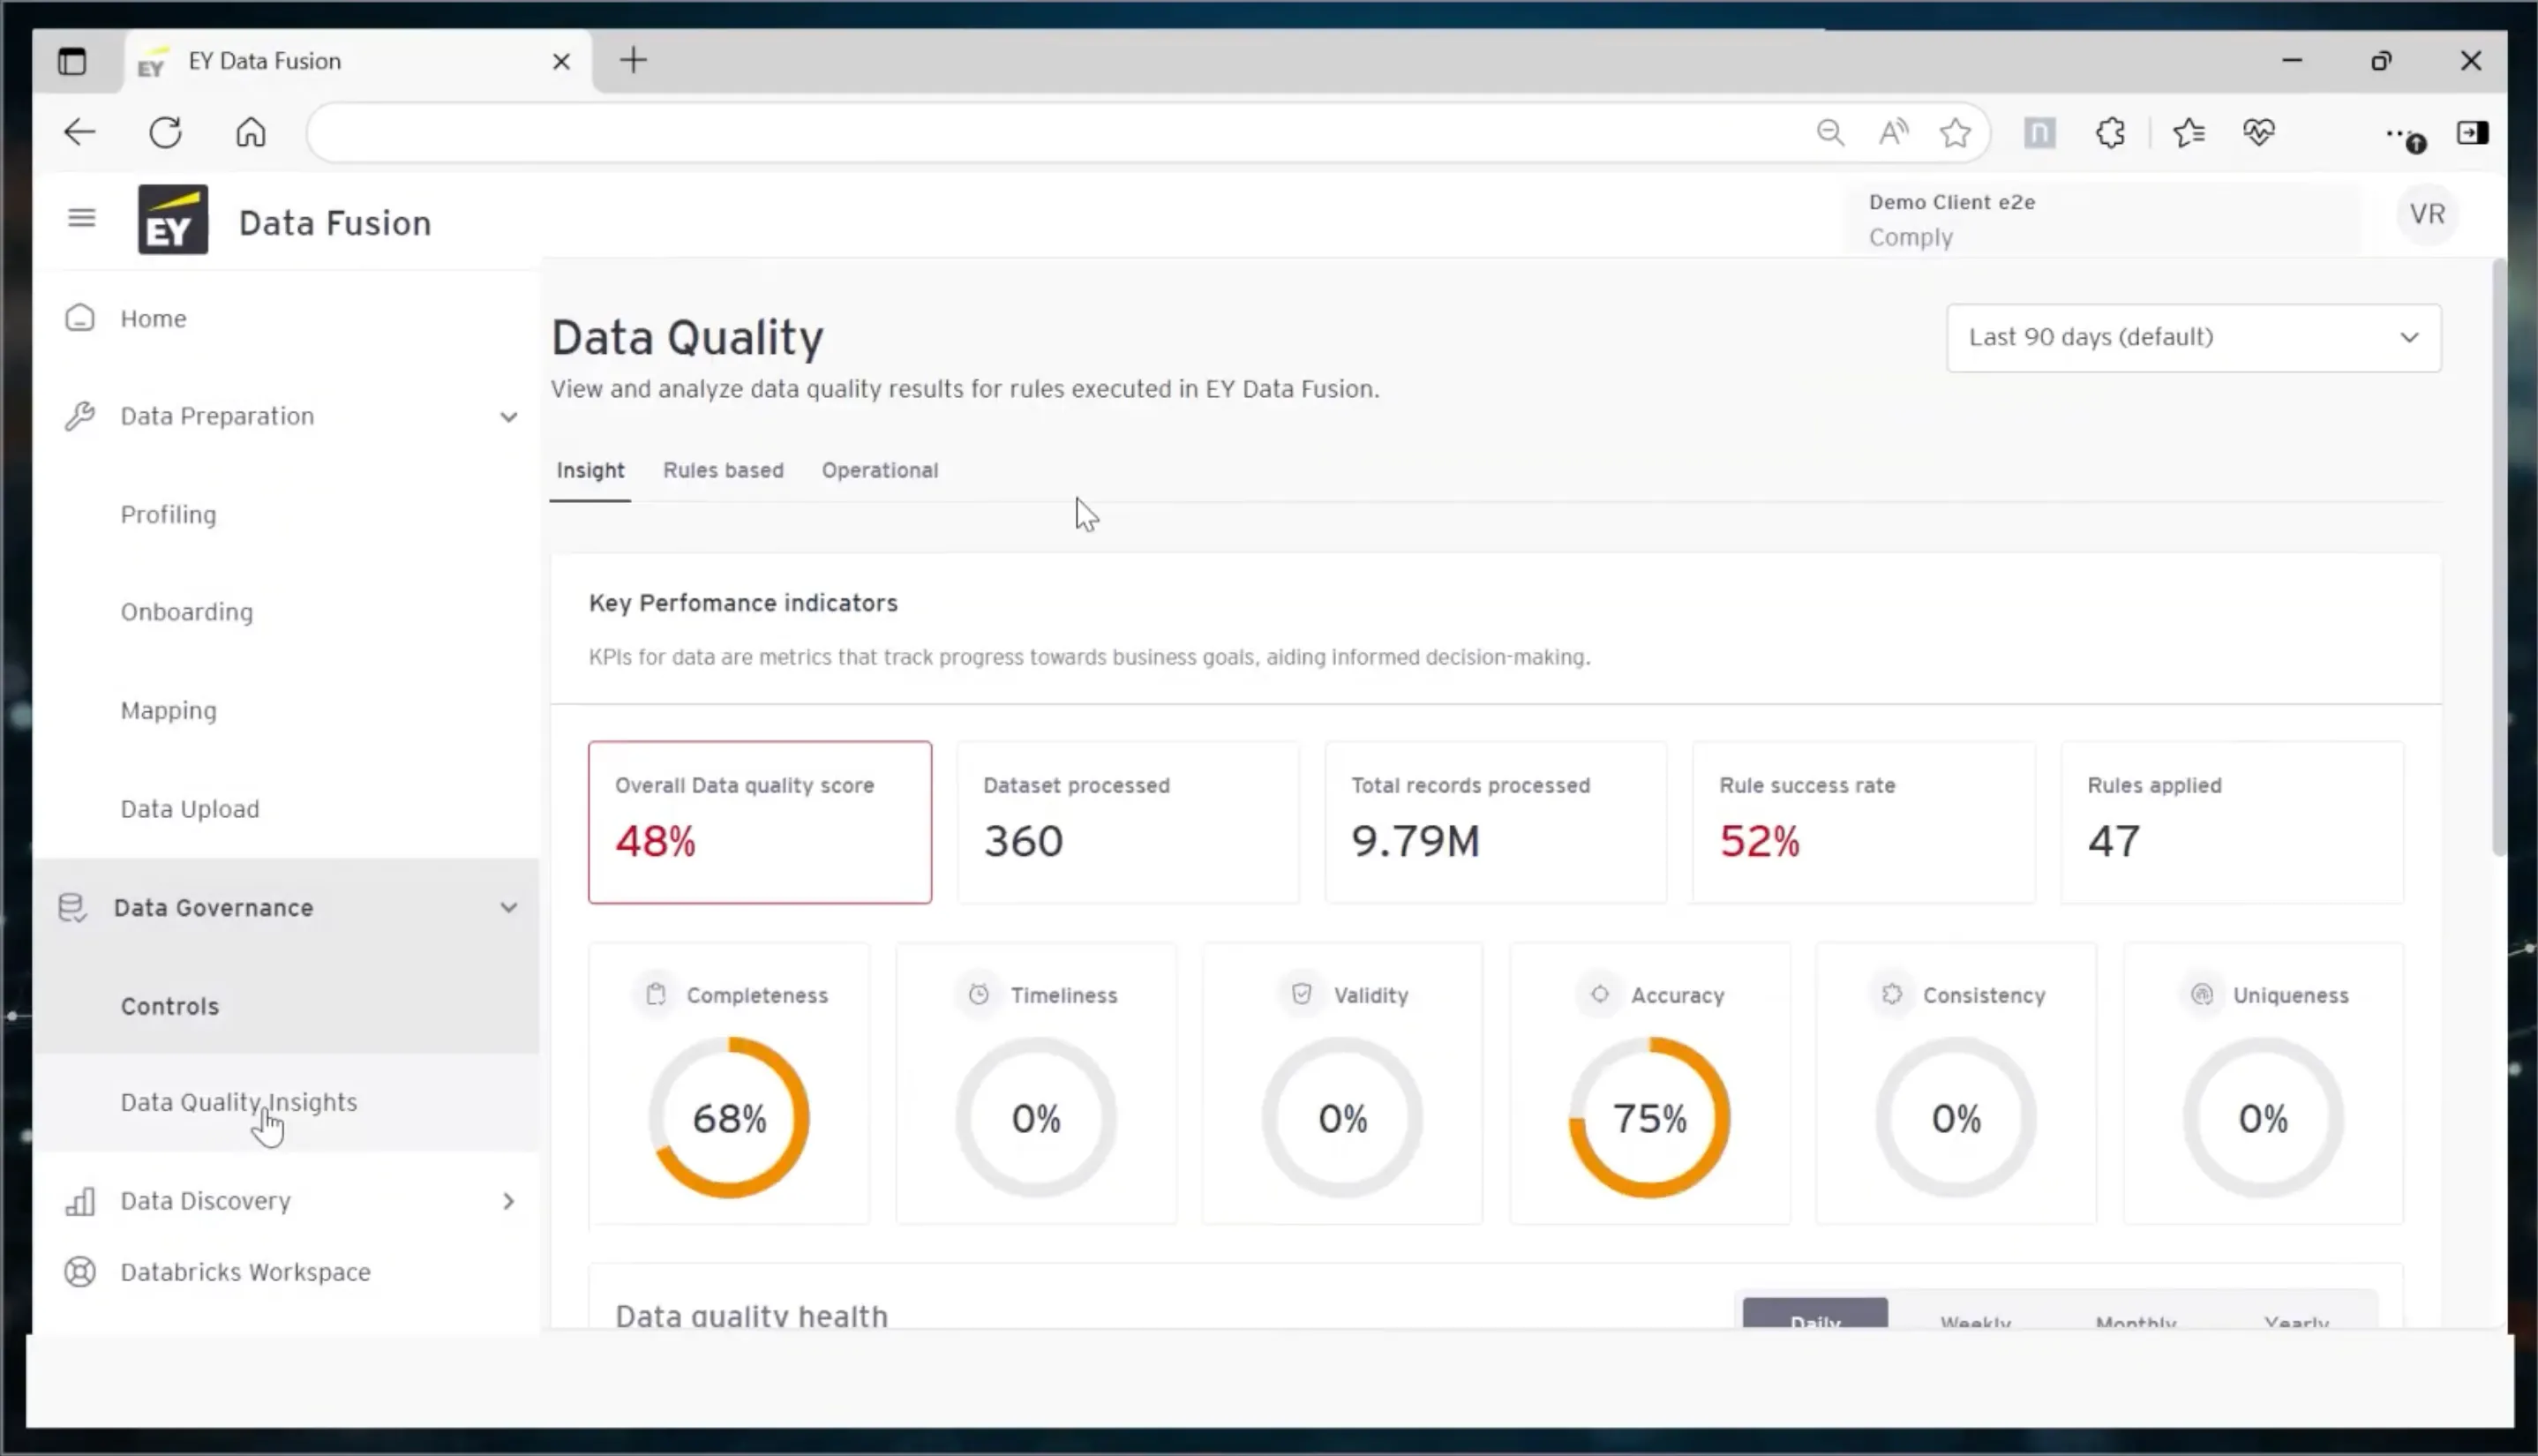
Definer og håndhæv hver kundes regler, og følg resultaterne i Data Quality Insights.
- 03
Data Discovery
Udforsk rå og kuraterede data med SQL-forespørgsler i Data Explorer.
- 04
Data Operations
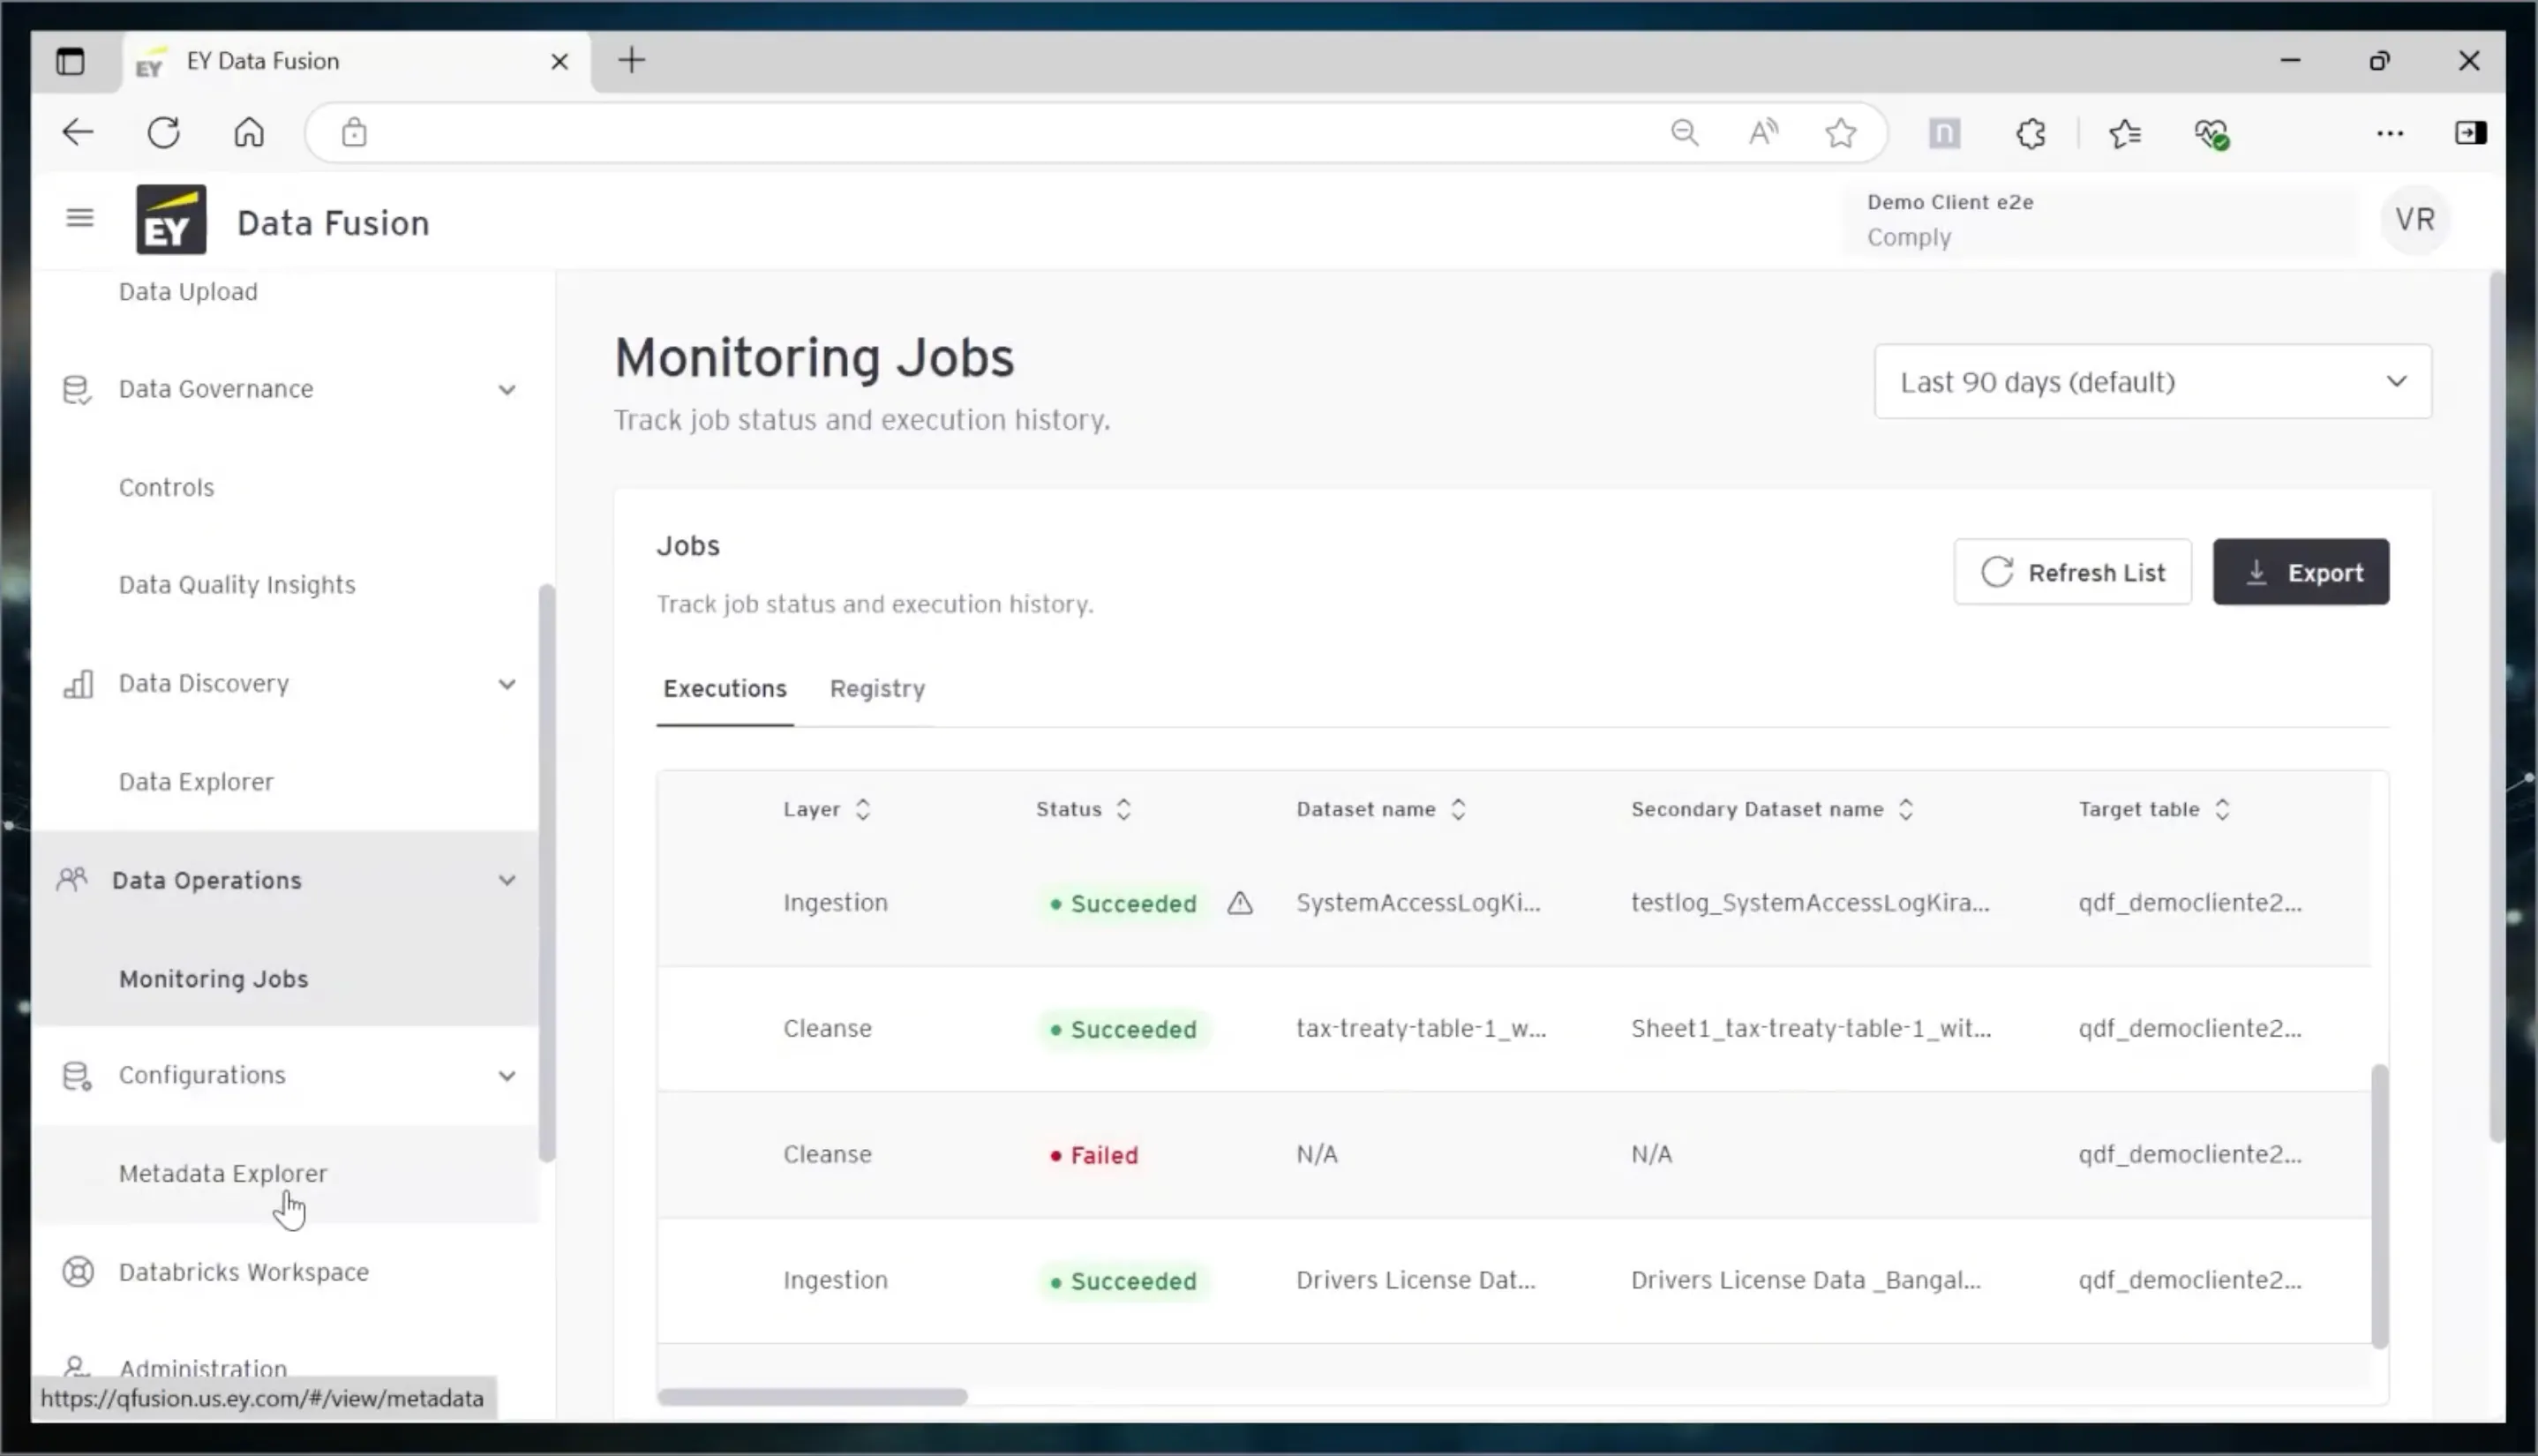
Følg status og kørselshistorik for hvert datajob.
- 05
Configurations
Forespørg platformens metadata via Metadata Explorer.
- 06
App Gallery
AI- og machine learning-apps, der udvider platformen, fra anomalidetektion til intelligent dokumentbehandling.
AI som en del af arbejdsgangen
- AI
Data Mapping Agent
Opretter eller forbedrer en datamapping ud fra en forespørgsel skrevet i almindeligt sprog.
- AI
Rule Agent
Skriver automatisk SQL'en til en datakvalitetsregel, og brugeren kan stadig redigere den.
- AI
Registrering af følsomme data
Finder personlige og følsomme oplysninger i dataene.
- AI
AI-drevet datakvalitet
Opdager anomalier og afvigere, før de bliver til problemer.
Skærme fra videoen
03 · MIN ROLLE
Platformens ledende designer
Jeg træffer designbeslutningerne for Data Fusion, og jeg udfører dem: fra at forstå et krav sammen med udviklerne, over flowet, til de endelige high-fidelity-skærme, der går i udvikling. Jeg designer også platformens varianter, som KMS og de micro frontend-apps, der kommer til.
- 01
Designbeslutninger
Jeg bestemmer, hvordan hver funktion virker og ser ud, og jeg står på mål for beslutningerne over for stakeholders og tech leads.
- 02
Udførelse fra start til slut
Flows, wireframes, prototyper og high-fidelity-skærme, bygget med Motif, EY's designsystem.
- 03
At oversætte kompleksitet
Jeg gør data engineering-krav til brugerflader, som forretningsbrugere kan forstå og bruge.
- 04
Kvalitet efter overlevering
Jeg sammenligner det byggede med designet og påpeger afvigelser, før de når produktion.
Dem, jeg arbejder med hver dag
- Managing DirectorProduktejerskab og vision
- 3 Tech Leads1 med fokus på AI, 2 på produkt
- Data EngineersPipelines, regler og datalogik
- Product ManagerRoadmap og prioriteter
- Product OwnerKrav og backlog
- Scrum MasterSprints og ceremonier
- UdviklereFrontend, backend og AI
Én platform, flere produkter
Data Fusion
Kerneplatformen: indlæsning, governance, datakvalitet, dataopdagelse og drift.
KMS Fusion
En ny app bygget oven på Data Fusion, der gør ustrukturerede dokumenter til et søgbart vidensbibliotek.
Micro frontend-apps
En navigationsmodel, der lader uafhængige apps leve inde i Data Fusion som én samlet oplevelse.
04 · UDFORDRINGEN
At lære datas sprog
Min største udfordring var ikke brugerfladen, men domænet. Data engineering er fuld af begreber, der er usynlige for de fleste, og jeg kunne ikke designe gode skærme til noget, jeg ikke forstod.
Sådan lukkede jeg hullet
- 01
Stillede mange spørgsmål
Daglig kontakt med data engineers og tech leads. Jeg blev ved med at spørge, til jeg kunne forklare hvert begreb med mine egne ord.
- 02
Research
Jeg studerede ETL, datakvalitet, governance, ontologier og forskellen på strukturerede og ustrukturerede data.
- 03
Skrev det ned
Guidedokumenter og flowcharts, der forklarer nøglebegreberne, valideret med stakeholders. De blev også en reference for teamet.
- 04
Designede til ikke-eksperter
Fordi jeg selv havde været nybegynder, vidste jeg, hvor sproget var for teknisk, og kæmpede for tydeligere tekster og guidede flows.
Nogle af de ord, jeg skulle lære
- ETL
- Extract, Transform, Load. At hente data fra en kilde, give dem den rette form og gemme dem, hvor de er nyttige.
- Data profiling
- At gennemgå et datasæt for at forstå det: struktur, værdifordeling, tomme felter og afvigere.
- Data mapping
- At definere, hvordan felterne i en rå kilde bliver til felter i en kurateret standardmodel.
- Data quality rule
- Et tjek, som dataene skal bestå, fx "alle konti har en ejer". Skrives typisk i SQL.
- PII / PCI
- Personoplysninger og betalingskortdata. Følsomme data, der skal findes og beskyttes.
- Tenant
- En kundes isolerede rum på en platform, der deles af mange kunder.
- Ontology
- Et kort over begreber og hvordan de hænger sammen, fx "Lasagne indeholder Ost".
- Unstructured data
- Information, der ikke ligger i tabeller, som PDF'er, formularer og rapporter.
Resten af denne case study er låst
Indtast adgangskoden for at se resten.
Forkert adgangskode. Prøv igen.