CASE STUDY · EY
Data Fusion & KMS
Design av gränssnittet för EY:s AI-drivna dataplattform för finansiella institutioner, och de nya appar som byggs ovanpå den.
- Min roll
- Lead UX/UI Designer
- Företag
- EY
- Designade skärmar
- 100+
- Verktyg
- Figma, Miro, Motif (EY:s designsystem)
- Metod
- Scrum, Azure DevOps
- 150+kunder i produktion
- 9 000+datakällor
- 6 000+affärsregler
- Upp till 50%snabbare utveckling av pipelines
Offentliga siffror från EY:s officiella presentation av plattformen.
01 · PLATTFORMEN
Se den i användning
Det här är EY:s officiella presentation av Data Fusion. Den går igenom plattformens viktigaste moduler: dataförberedelse, styrning, datakvalitet, dataupptäckt och drift.
02 · BAKGRUND
Vad är Data Fusion?
Enkelt uttryckt
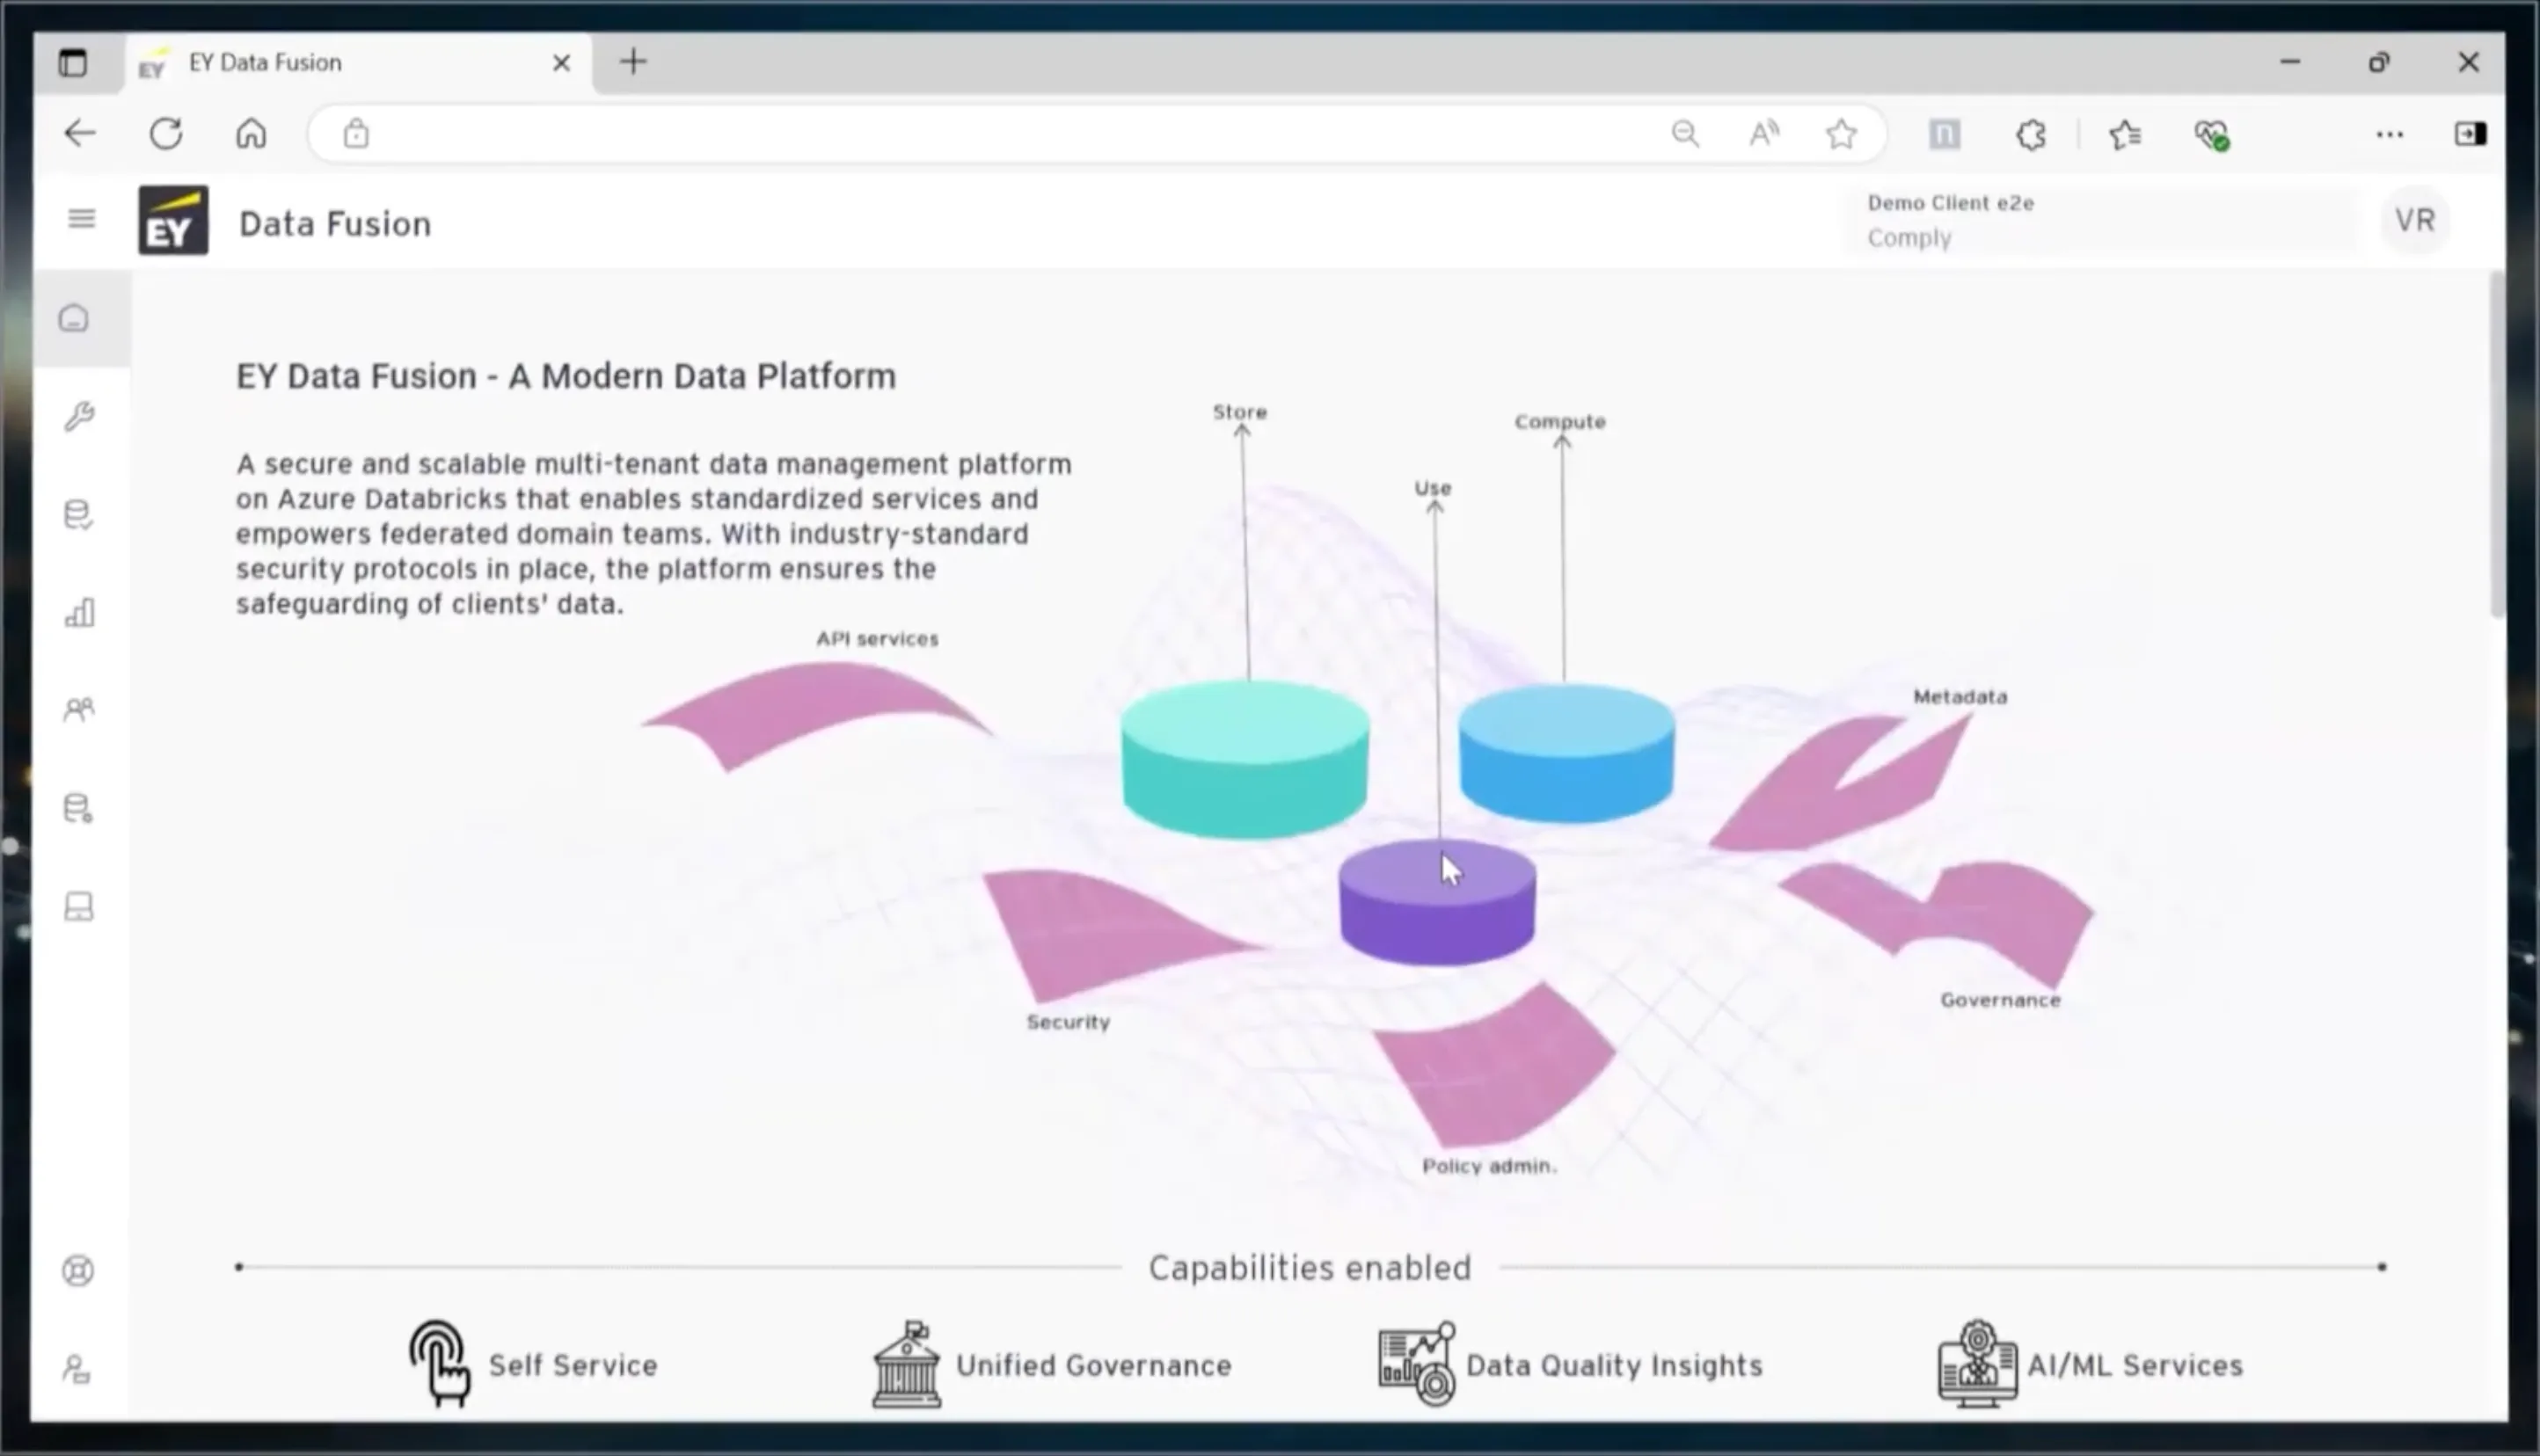
Banker och finansiella institutioner tar emot data från tusentals håll: interna system, filer, partner. Innan den datan kan användas med förtroende för rapporter, beslut eller AI måste någon hämta in den, rensa den, kontrollera den mot affärsreglerna och organisera den. Data Fusion är plattformen där allt det sker.
Det är en molnbaserad, AI-driven multi-tenant-plattform byggd på Databricks. En plattform betjänar många kunder, var och en i sitt eget isolerade utrymme, och ett low-code / no-code-gränssnitt låter affärs- och tekniska team arbeta med data utan att skriva kod.
Vad plattformen gör
- 01
Data Preparation
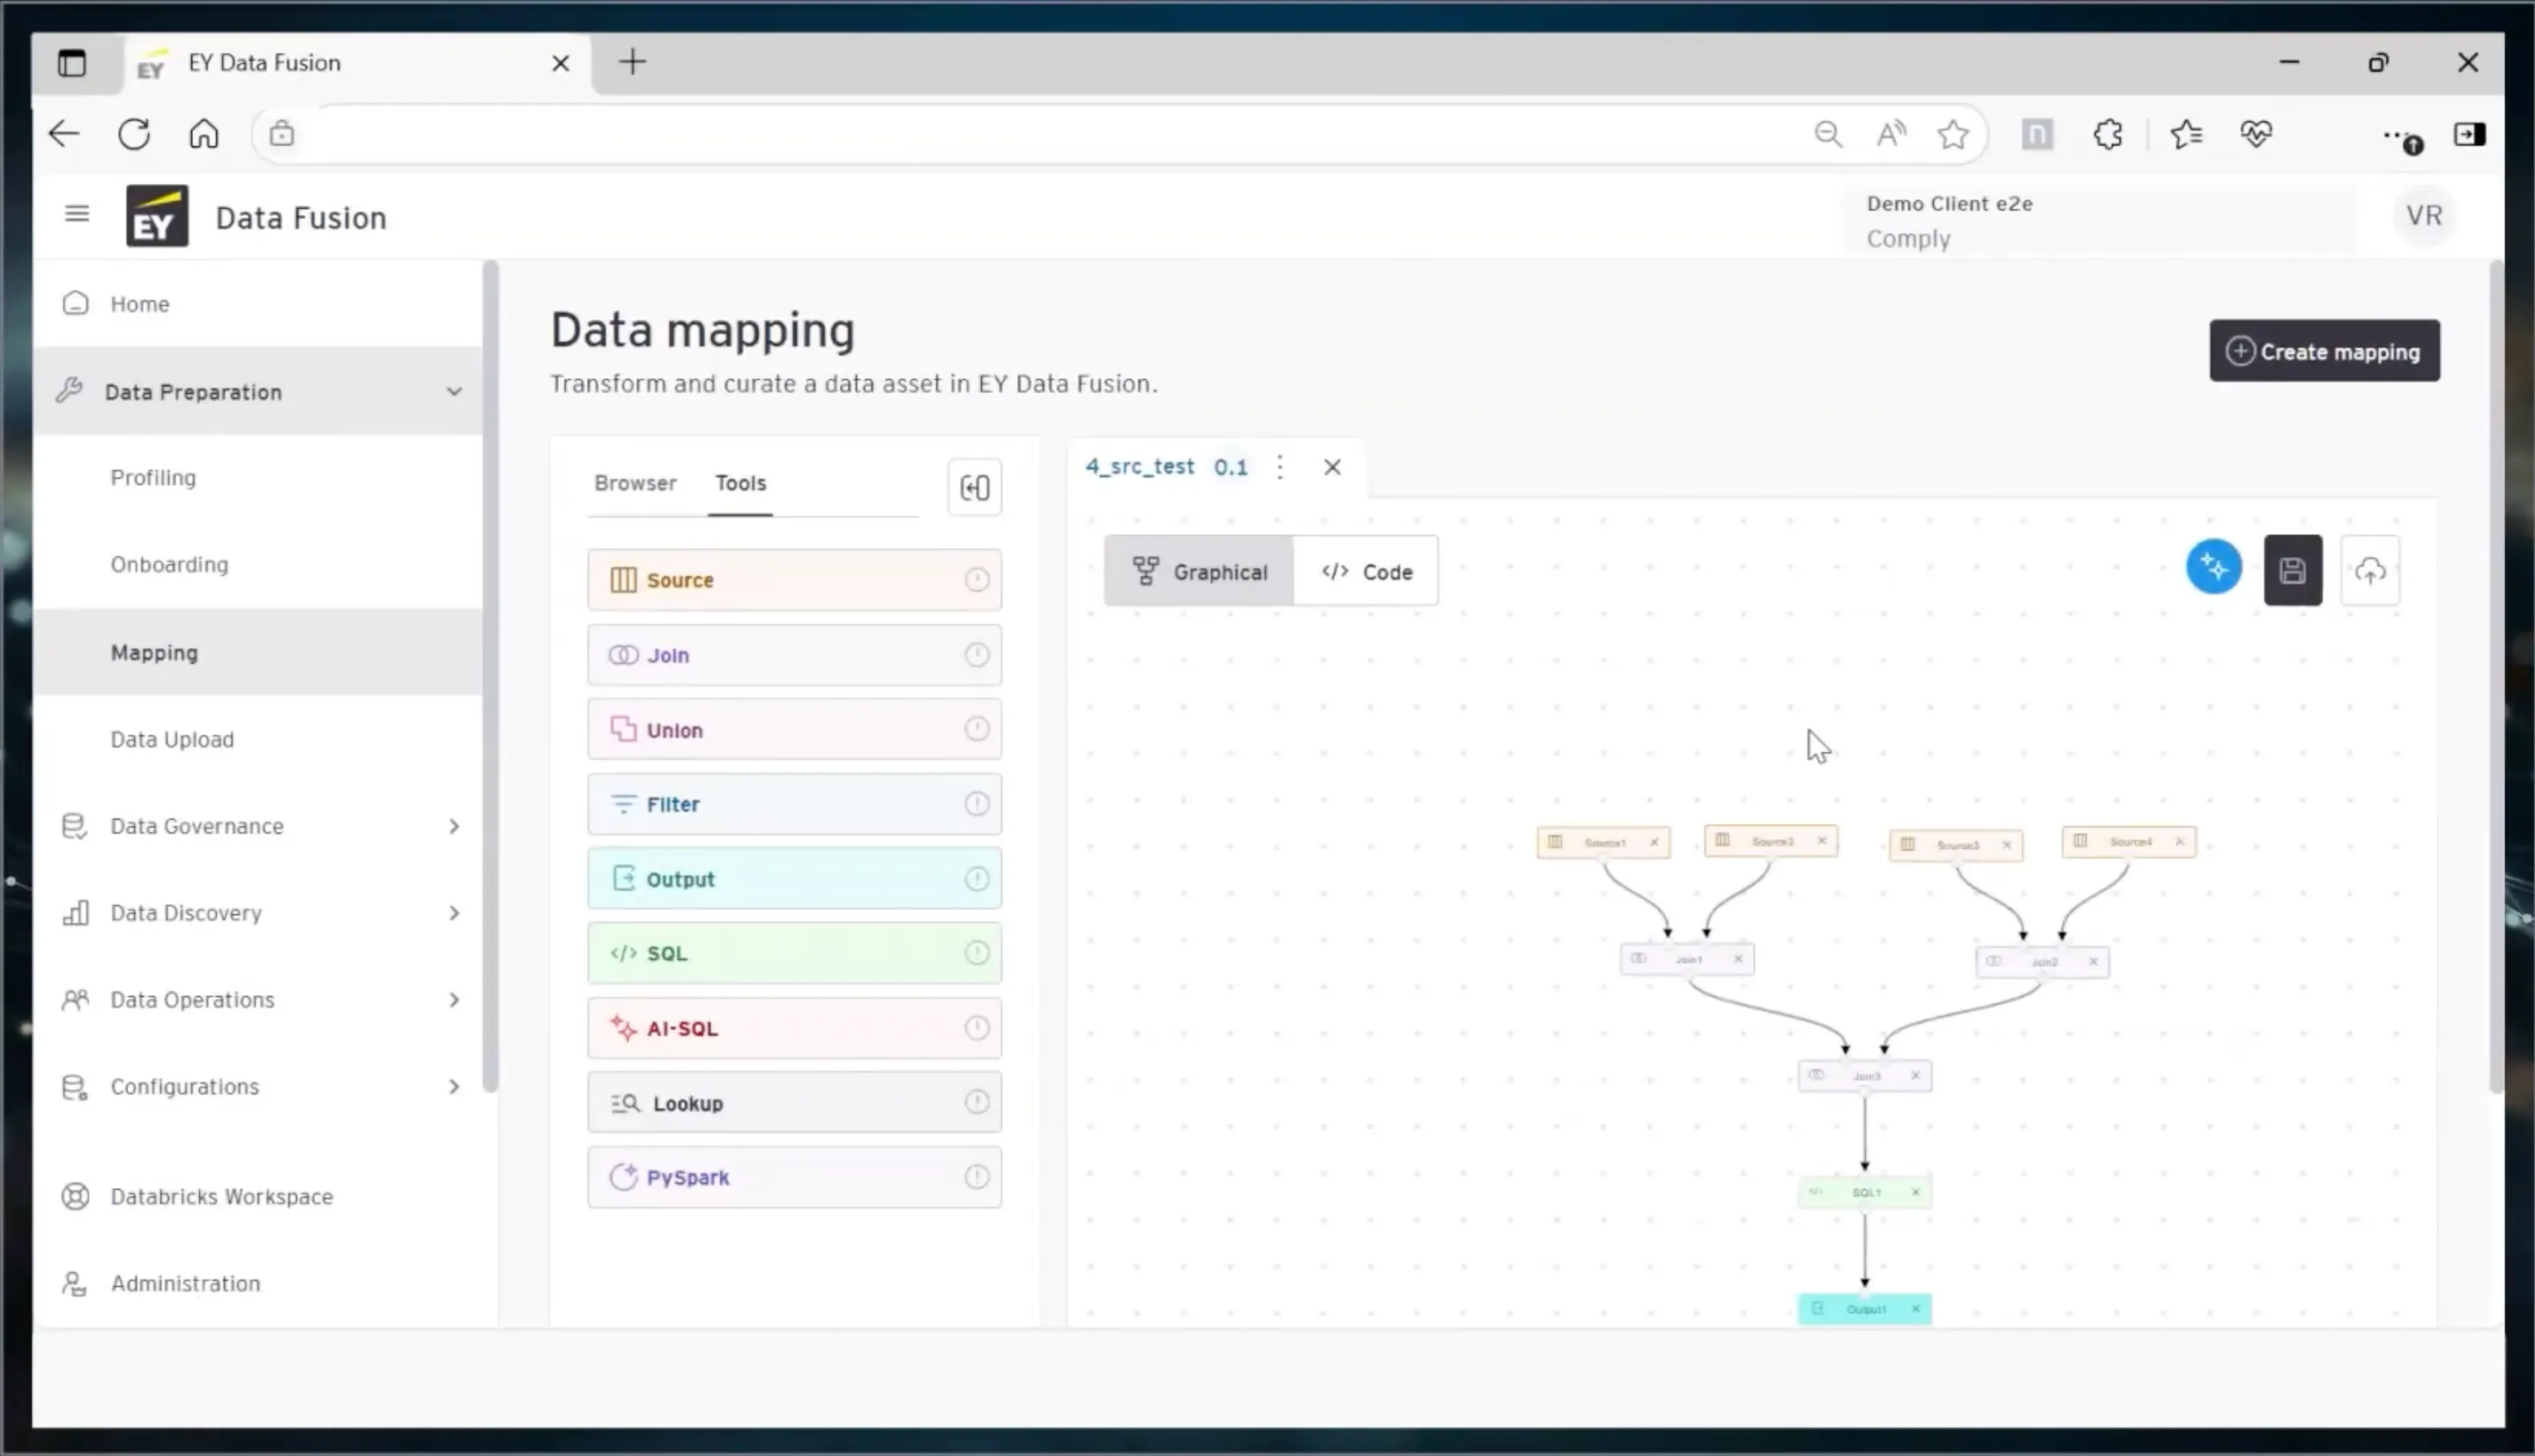
Ladda upp filer, analysera dem för mönster och avvikelser, lägg till nya datakällor och mappa rådata till kurerade dataset.
- 02
Data Governance
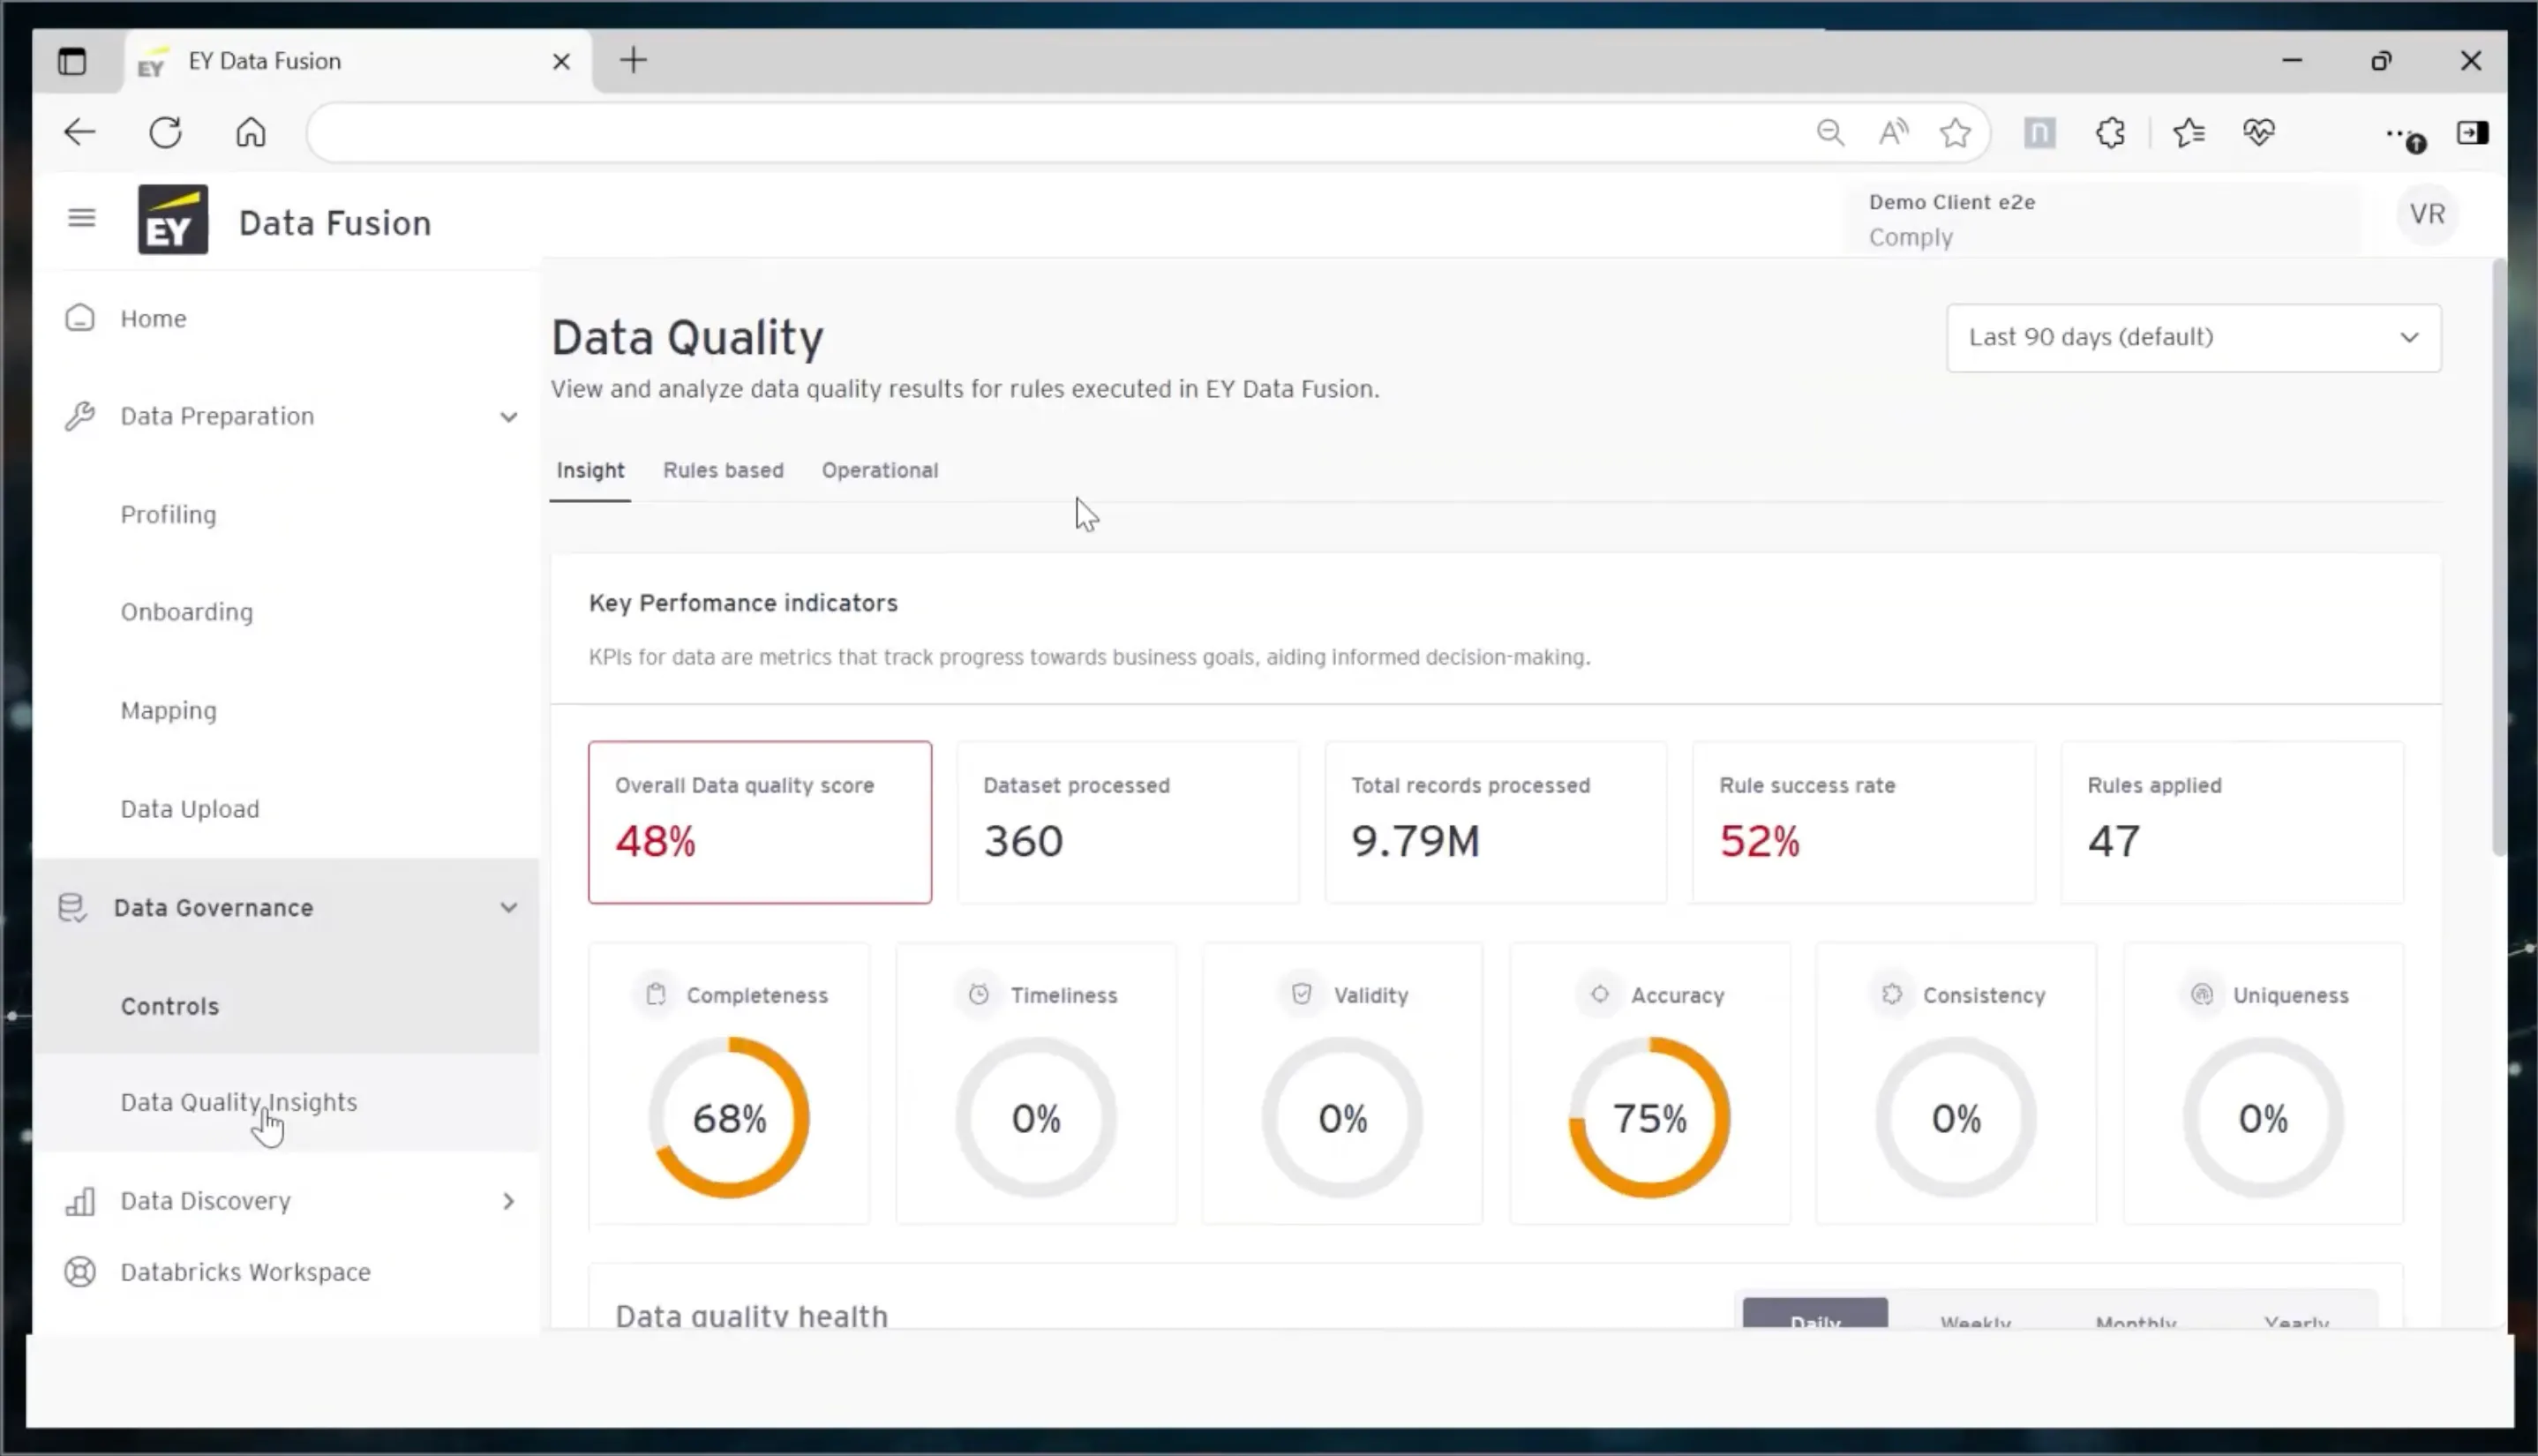
Definiera och upprätthåll varje kunds regler, och följ resultaten i Data Quality Insights.
- 03
Data Discovery
Utforska rå och kurerad data med SQL-frågor i Data Explorer.
- 04
Data Operations
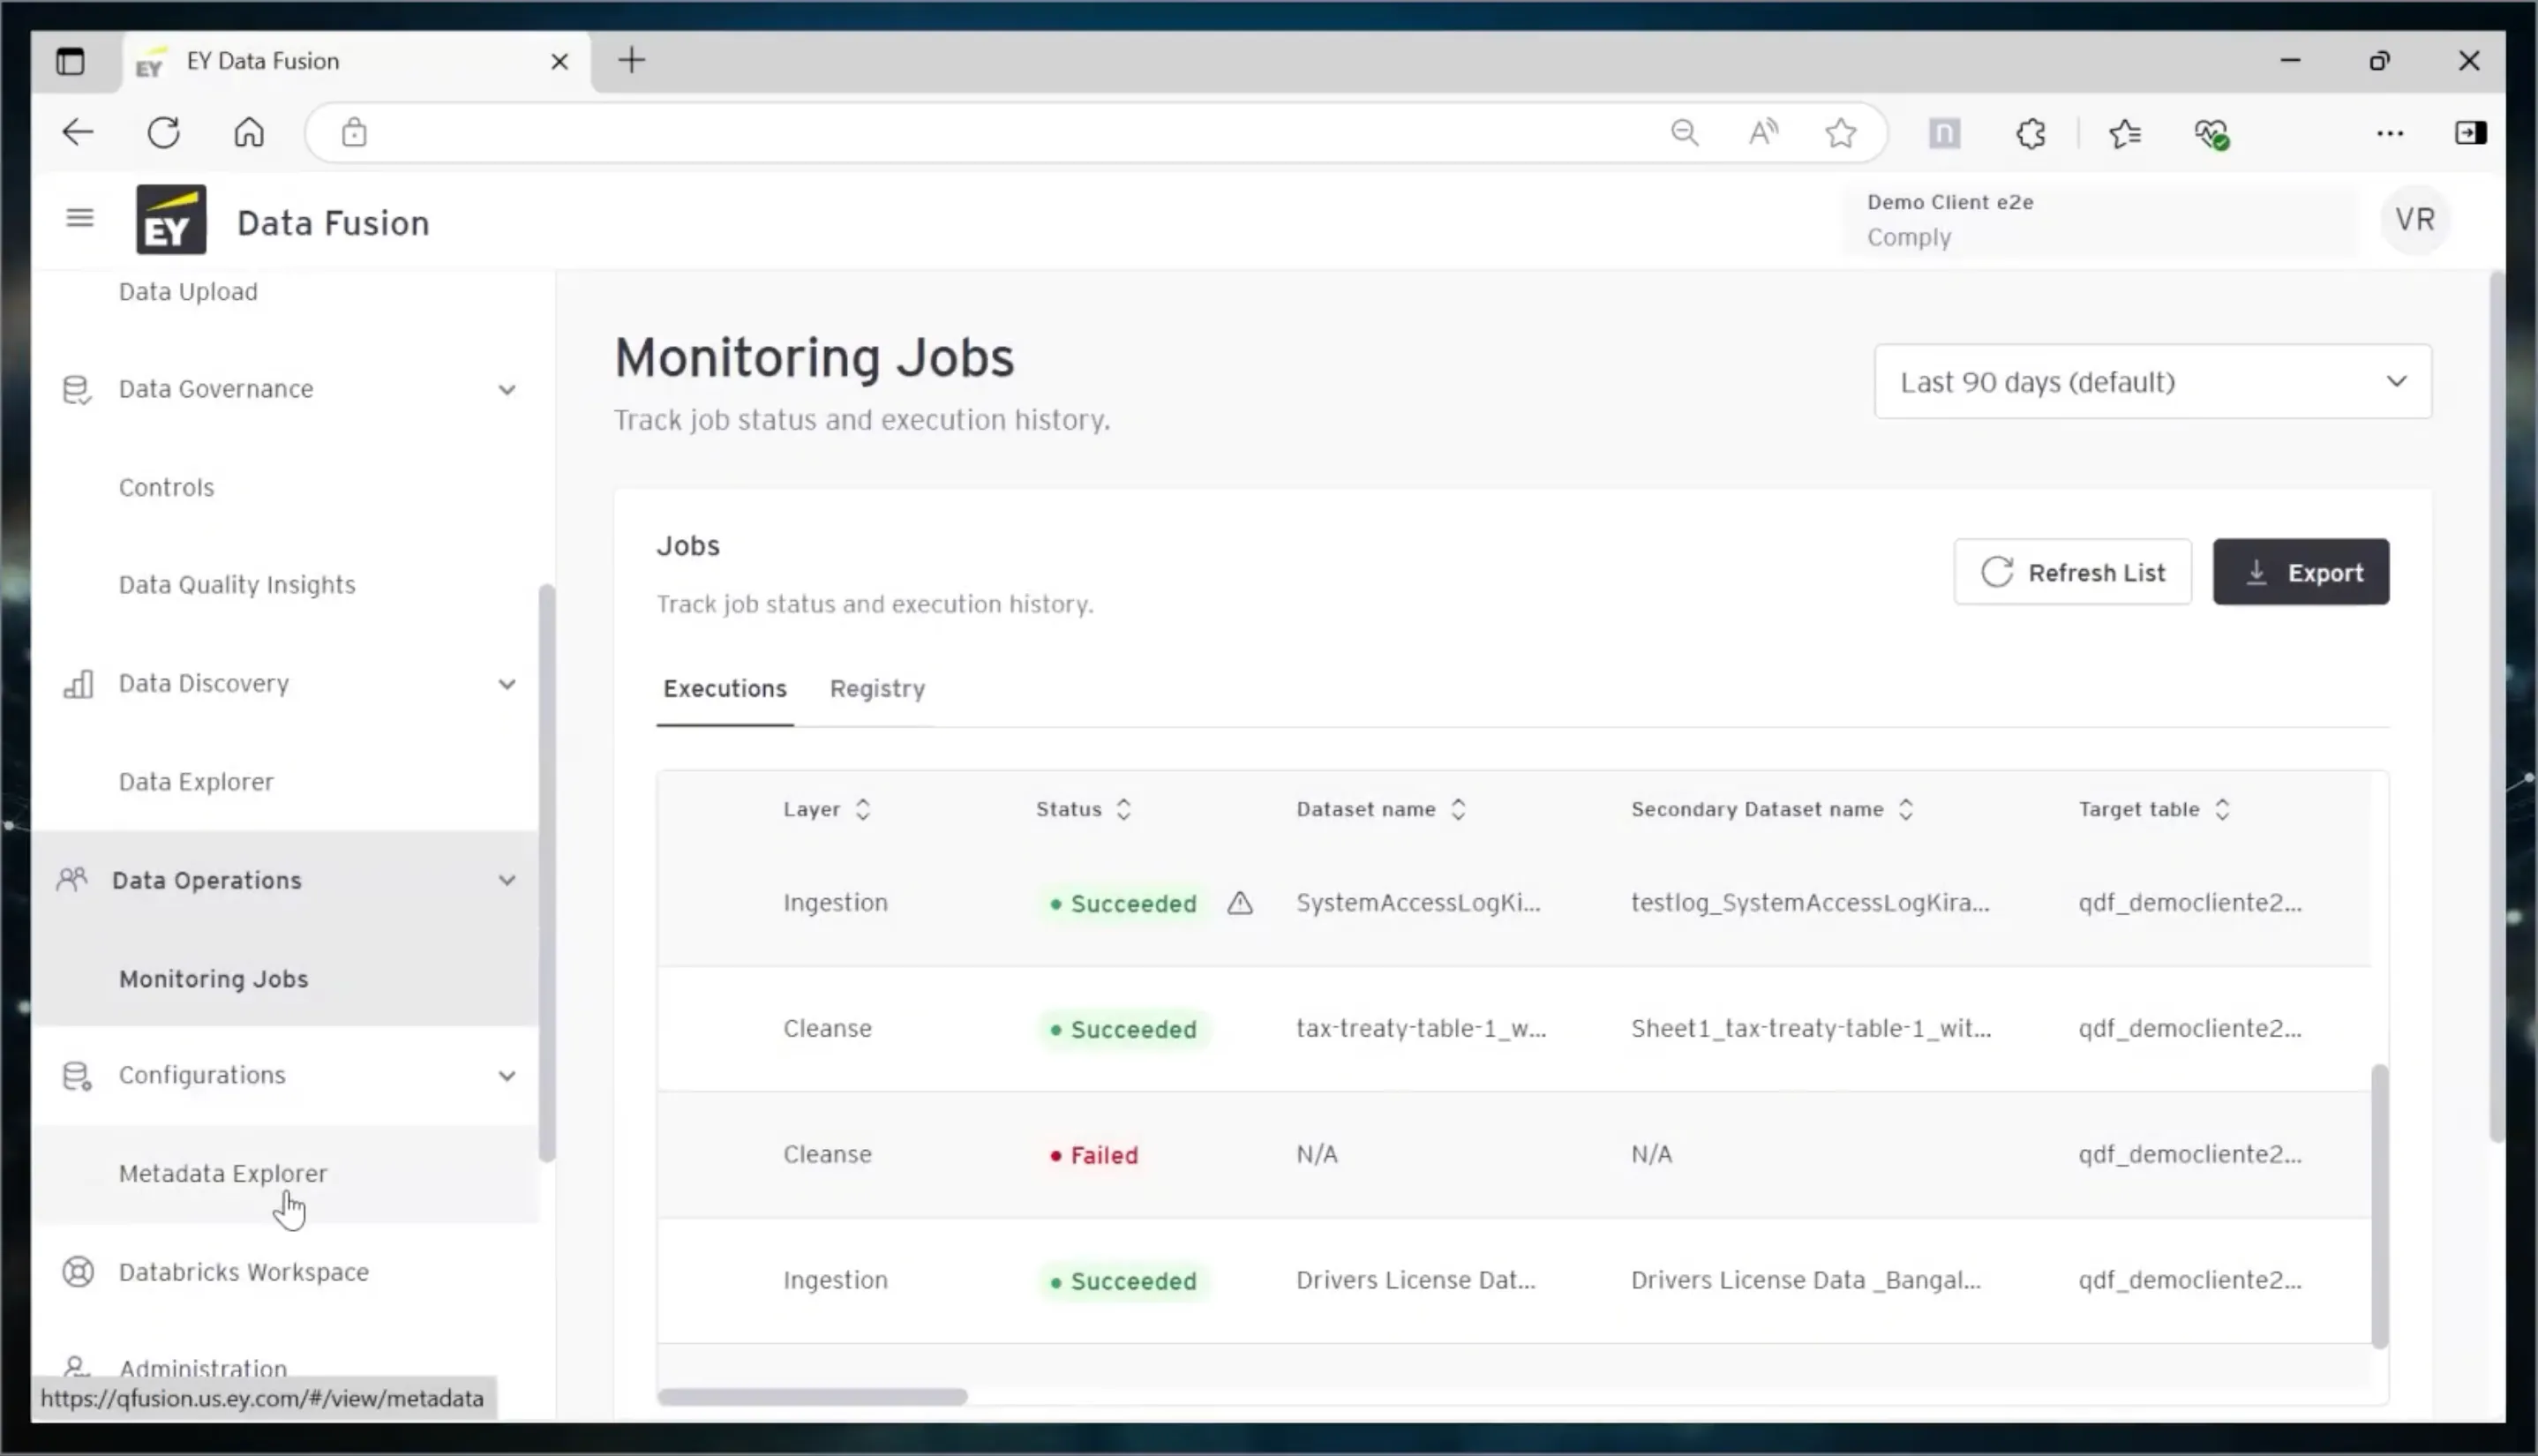
Följ status och körhistorik för varje datajobb.
- 05
Configurations
Fråga plattformens metadata via Metadata Explorer.
- 06
App Gallery
AI- och maskininlärningsappar som utökar plattformen, från avvikelsedetektering till intelligent dokumenthantering.
AI som en del av arbetsflödet
- AI
Data Mapping Agent
Skapar eller förfinar en datamappning utifrån en förfrågan skriven på vanligt språk.
- AI
Rule Agent
Skriver automatiskt SQL-koden för en datakvalitetsregel, och användaren kan fortfarande redigera den.
- AI
Identifiering av känslig data
Hittar personlig och känslig information i datan.
- AI
AI-driven datakvalitet
Upptäcker avvikelser och extremvärden innan de blir problem.
Skärmar från videon
03 · MIN ROLL
Plattformens ledande designer
Jag fattar designbesluten för Data Fusion och genomför dem: från att förstå ett krav tillsammans med utvecklarna, via flödet, till de slutliga high-fidelity-skärmarna som går till utveckling. Jag designar också plattformens varianter, som KMS och de micro frontend-appar som ansluter.
- 01
Designbeslut
Jag bestämmer hur varje funktion fungerar och ser ut, och jag står för besluten inför stakeholders och tech leads.
- 02
Genomförande från början till slut
Flöden, wireframes, prototyper och high-fidelity-skärmar, byggda med Motif, EY:s designsystem.
- 03
Att översätta komplexitet
Jag gör om data engineering-krav till gränssnitt som affärsanvändare kan förstå och använda.
- 04
Kvalitet efter överlämning
Jag jämför det som byggts med designen och flaggar avvikelser innan de når produktion.
De jag arbetar med varje dag
- Managing DirectorProduktägarskap och vision
- 3 Tech Leads1 med fokus på AI, 2 på produkt
- Data EngineersPipelines, regler och datalogik
- Product ManagerRoadmap och prioriteringar
- Product OwnerKrav och backlog
- Scrum MasterSprintar och ceremonier
- UtvecklareFrontend, backend och AI
En plattform, flera produkter
Data Fusion
Kärnplattformen: inläsning, styrning, datakvalitet, dataupptäckt och drift.
KMS Fusion
En ny app byggd ovanpå Data Fusion som gör ostrukturerade dokument till ett sökbart kunskapsbibliotek.
Micro frontend-appar
En navigeringsmodell som låter fristående appar leva inuti Data Fusion som en enda upplevelse.
04 · UTMANINGEN
Att lära sig datans språk
Min största utmaning var inte gränssnittet, utan domänen. Data engineering är full av begrepp som är osynliga för de flesta, och jag kunde inte designa bra skärmar för något jag inte förstod.
Så stängde jag gapet
- 01
Ställde många frågor
Daglig kontakt med data engineers och tech leads. Jag fortsatte fråga tills jag kunde förklara varje begrepp med egna ord.
- 02
Research
Jag studerade ETL, datakvalitet, styrning, ontologier och skillnaden mellan strukturerad och ostrukturerad data.
- 03
Skrev ner det
Guidedokument och flödesscheman som förklarar nyckelbegreppen, validerade med stakeholders. De blev också en referens för teamet.
- 04
Designade för icke-experter
Eftersom jag själv varit nybörjare visste jag var språket var för tekniskt, och drev på för tydligare texter och guidade flöden.
Några av orden jag fick lära mig
- ETL
- Extract, Transform, Load. Att hämta data från en källa, ge den rätt form och spara den där den är användbar.
- Data profiling
- Att granska ett dataset för att förstå det: struktur, värdefördelning, tomma fält och extremvärden.
- Data mapping
- Att definiera hur fälten i en rå källa blir fält i en kurerad standardmodell.
- Data quality rule
- En kontroll som datan måste klara, till exempel "varje konto har en ägare". Skrivs oftast i SQL.
- PII / PCI
- Personuppgifter och betalkortsuppgifter. Känslig data som måste hittas och skyddas.
- Tenant
- En kunds isolerade utrymme på en plattform som delas av många kunder.
- Ontology
- En karta över begrepp och hur de hänger ihop, till exempel "Lasagne innehåller Ost".
- Unstructured data
- Information som inte ligger i tabeller, som PDF:er, formulär och rapporter.
Resten av den här case studyn är låst
Ange lösenordet för att se resten.
Fel lösenord. Försök igen.