ESETTANULMÁNY · EY
Data Fusion & KMS
Az EY pénzügyi intézményeknek szóló, MI-alapú adatplatformjának felülete, és a rá épülő új alkalmazások tervezése.
- Szerepem
- Lead UX/UI Designer
- Cég
- EY
- Megtervezett képernyők
- 100+
- Eszközök
- Figma, Miro, Motif (az EY design systemje)
- Módszertan
- Scrum, Azure DevOps
- 150+éles ügyfél
- 9 000+adatforrás
- 6 000+üzleti szabály
- Akár 50%gyorsabb pipeline-fejlesztés
Nyilvános adatok az EY hivatalos platformbemutatójából.
01 · A PLATFORM
Nézd meg működés közben
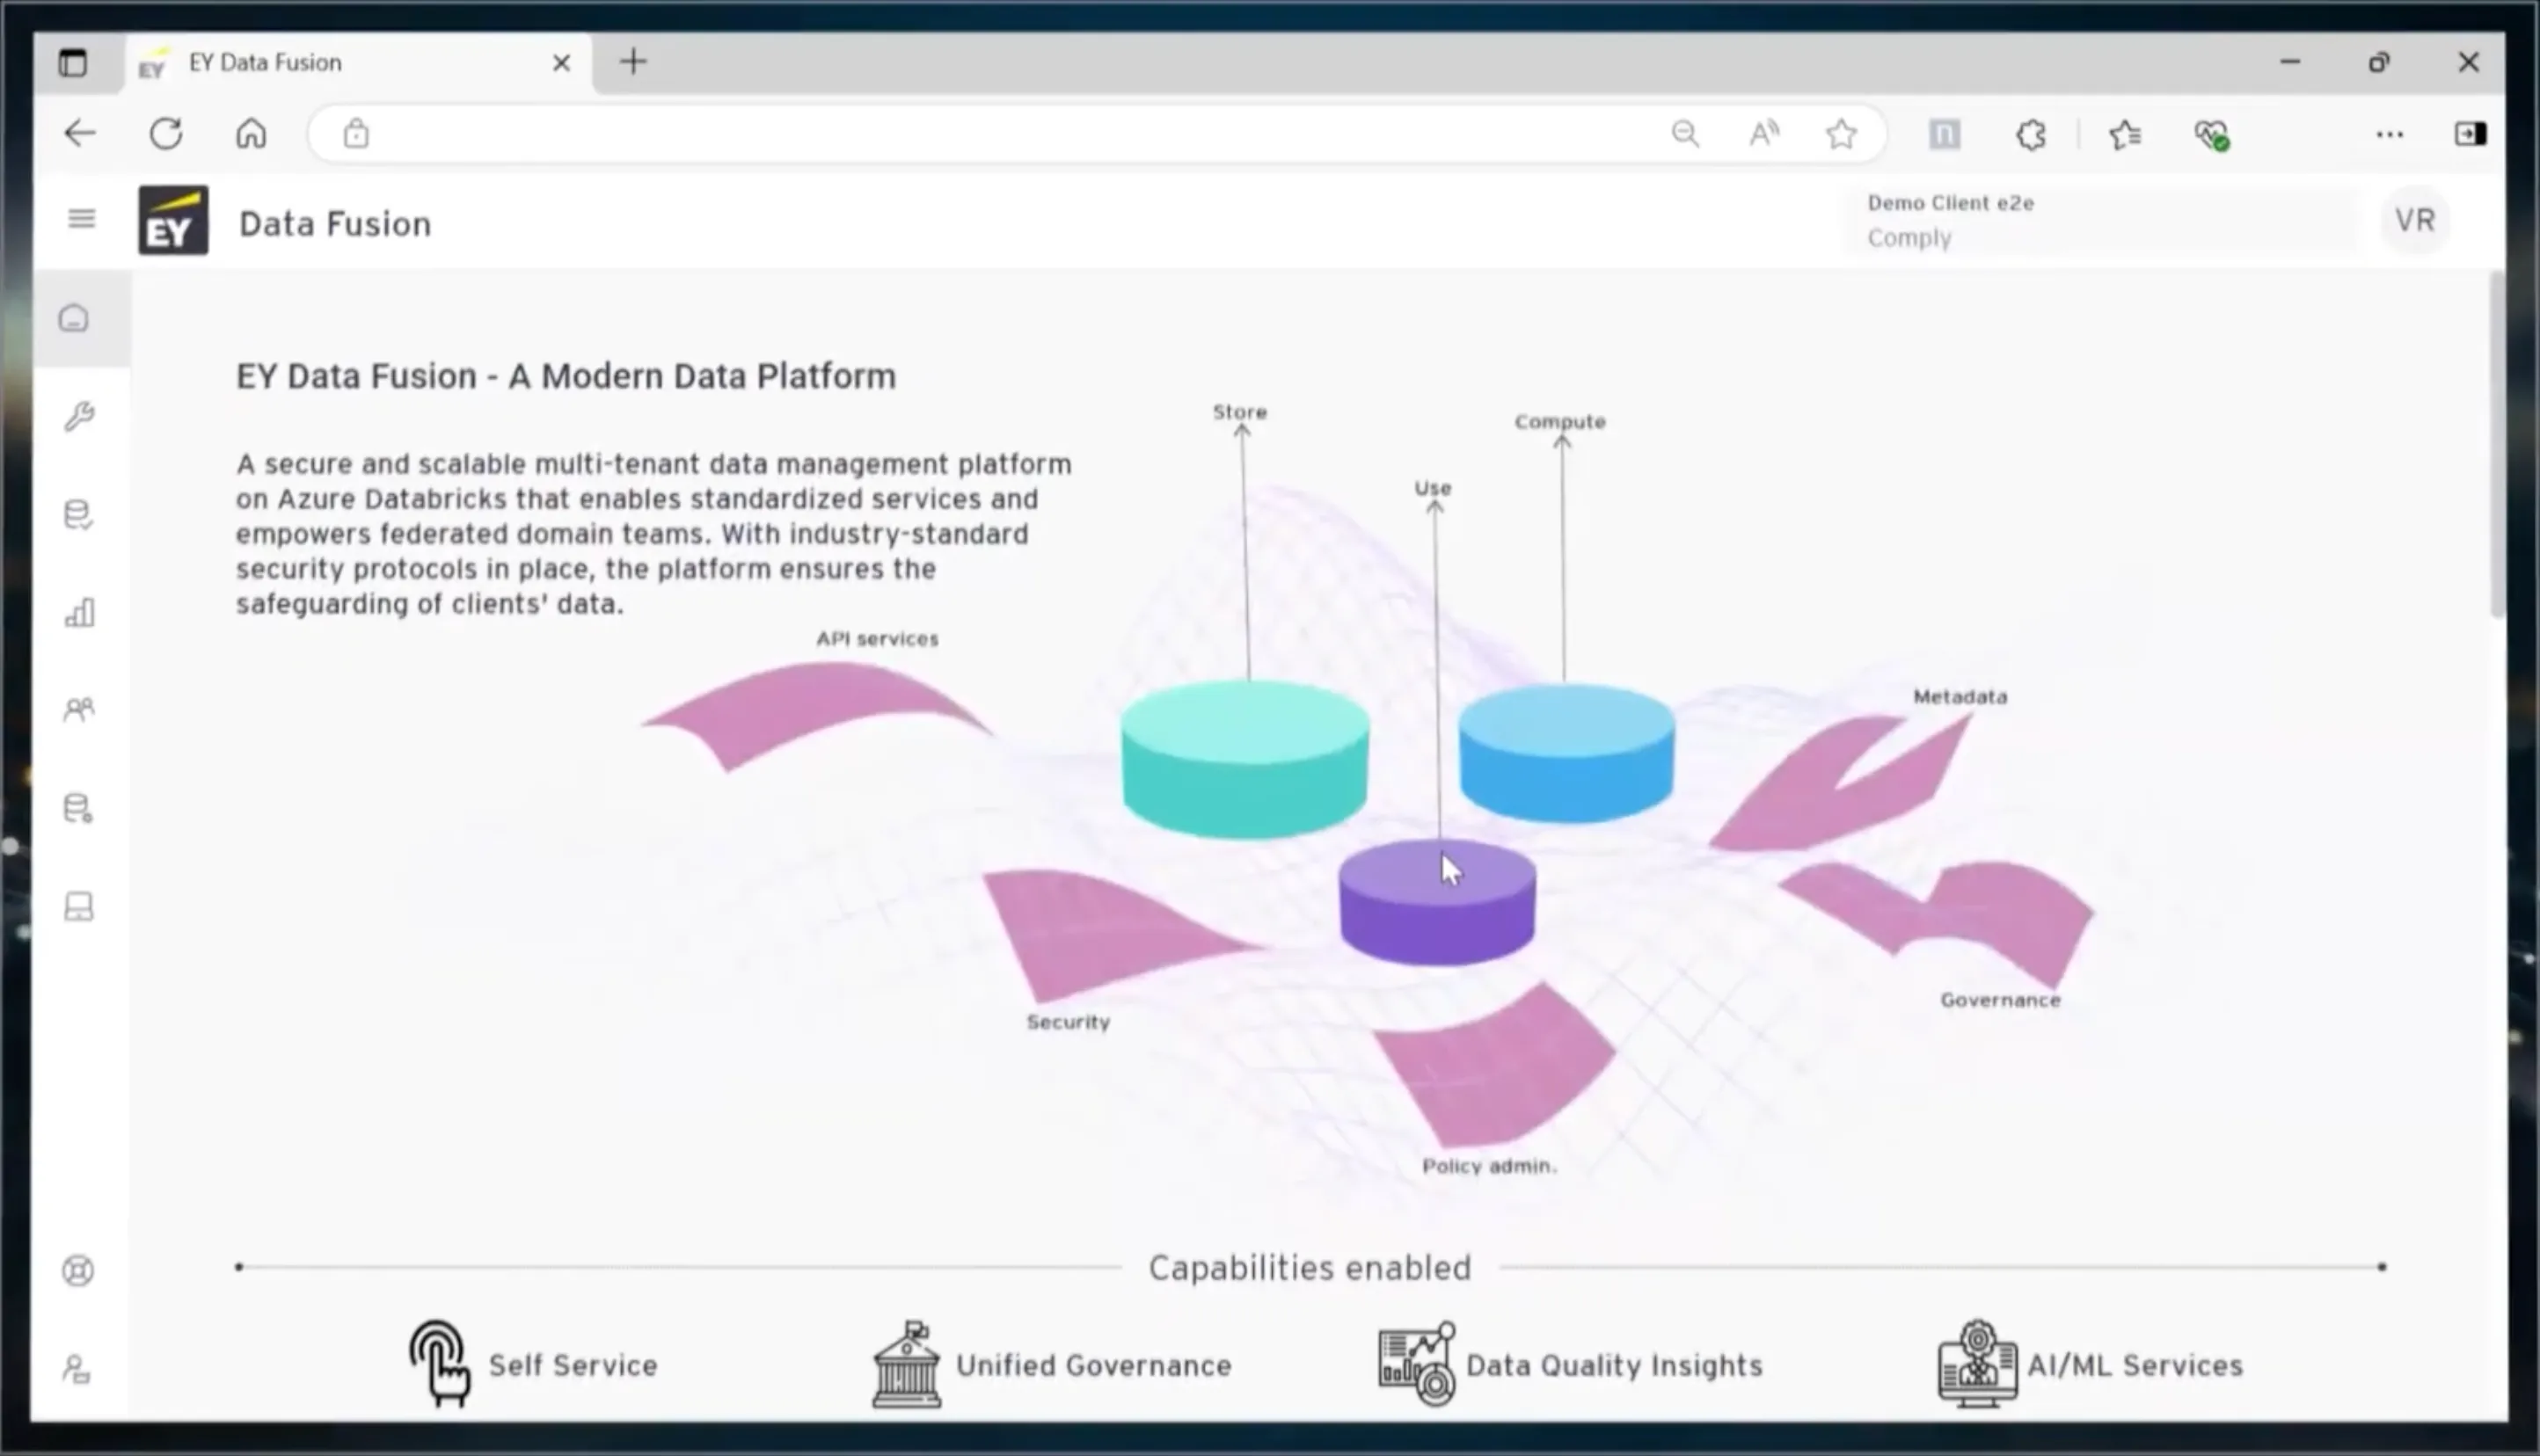
Ez a Data Fusion hivatalos EY-bemutatója. Végigveszi a platform fő moduljait: adatelőkészítés, adatirányítás, adatminőség, adatfeltárás és üzemeltetés.
02 · HÁTTÉR
Mi az a Data Fusion?
Egyszerűen fogalmazva
A bankok és pénzügyi intézmények több ezer helyről kapnak adatokat: belső rendszerekből, fájlokból, partnerektől. Mielőtt ezek az adatok megbízhatóak lennének jelentésekhez, döntésekhez vagy MI-hez, valakinek be kell hoznia, meg kell tisztítania, ellenőriznie kell az üzleti szabályok szerint, és rendszereznie kell őket. A Data Fusion az a platform, ahol mindez történik.
Felhőalapú, MI-vel támogatott, multi-tenant platform, amely a Databricksre épül. Egyetlen platform sok ügyfelet szolgál ki, mindegyiket a saját elszigetelt terében, a low-code / no-code felület pedig lehetővé teszi, hogy üzleti és technikai csapatok kódírás nélkül dolgozzanak az adatokkal.
Mit csinál a platform
- 01
Data Preparation
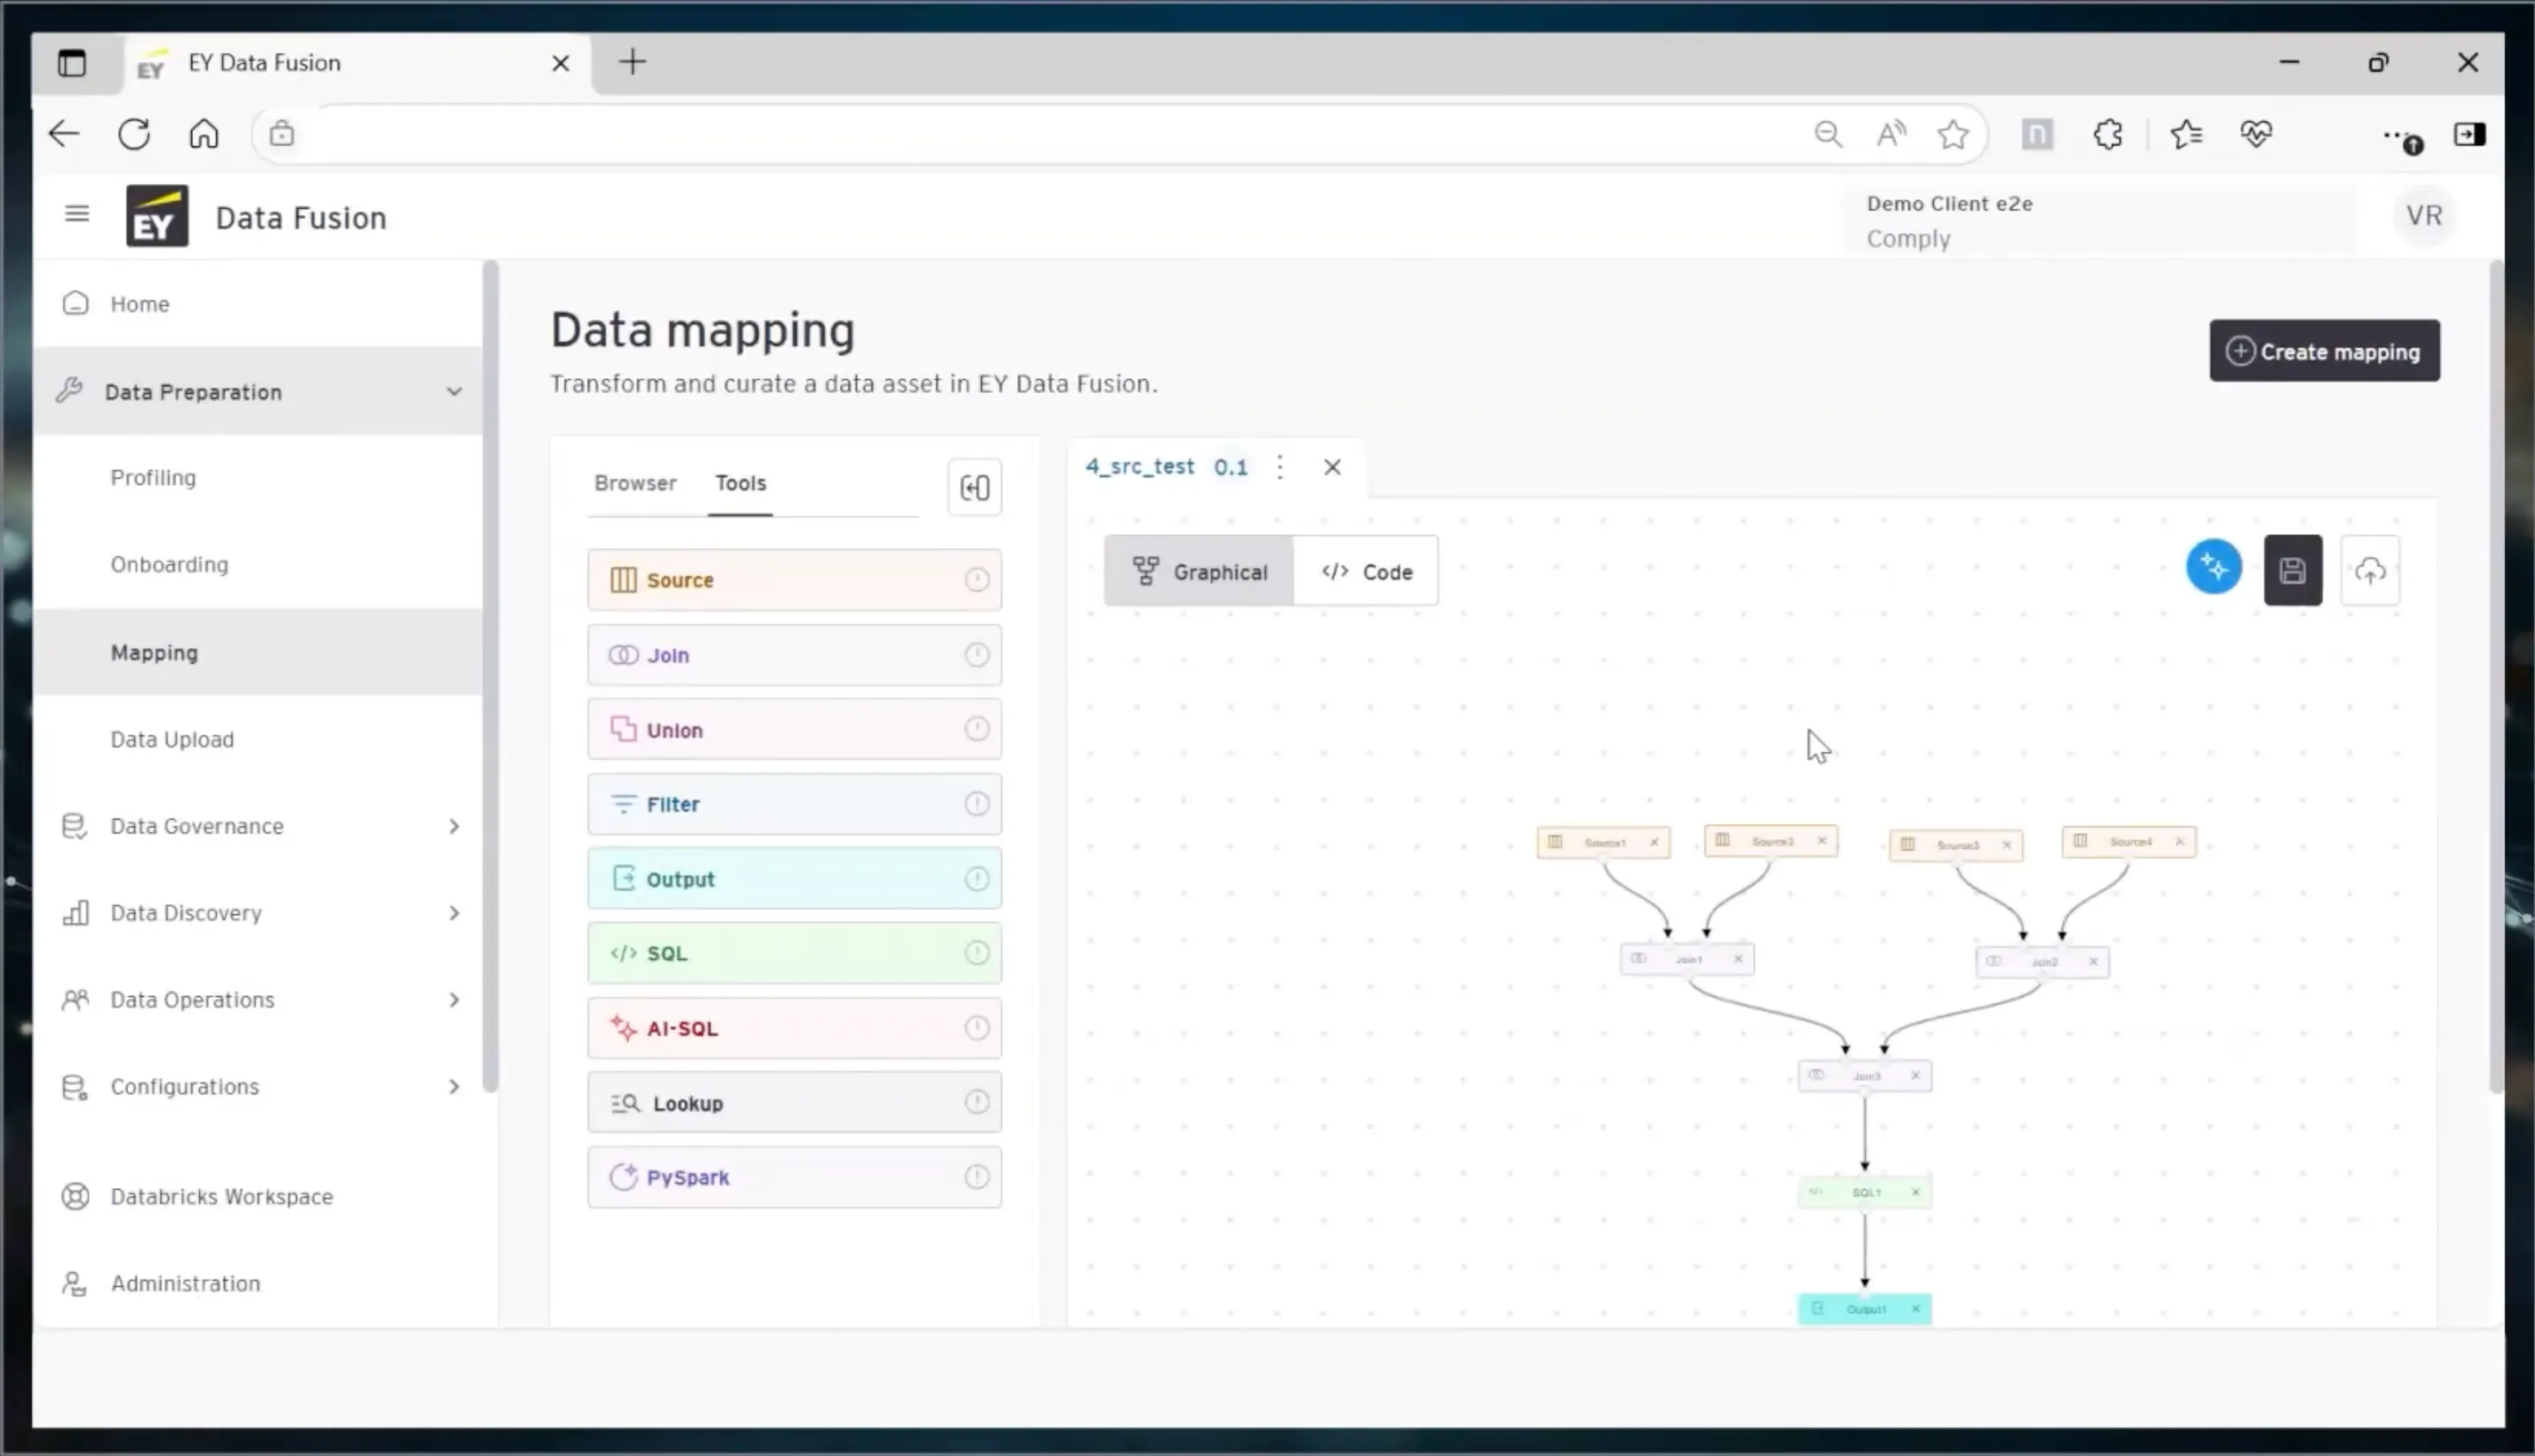
Fájlok feltöltése, elemzése minták és anomáliák után kutatva, új adatforrások bevezetése, és a nyers adatok rendezett adatkészletekké alakítása.
- 02
Data Governance
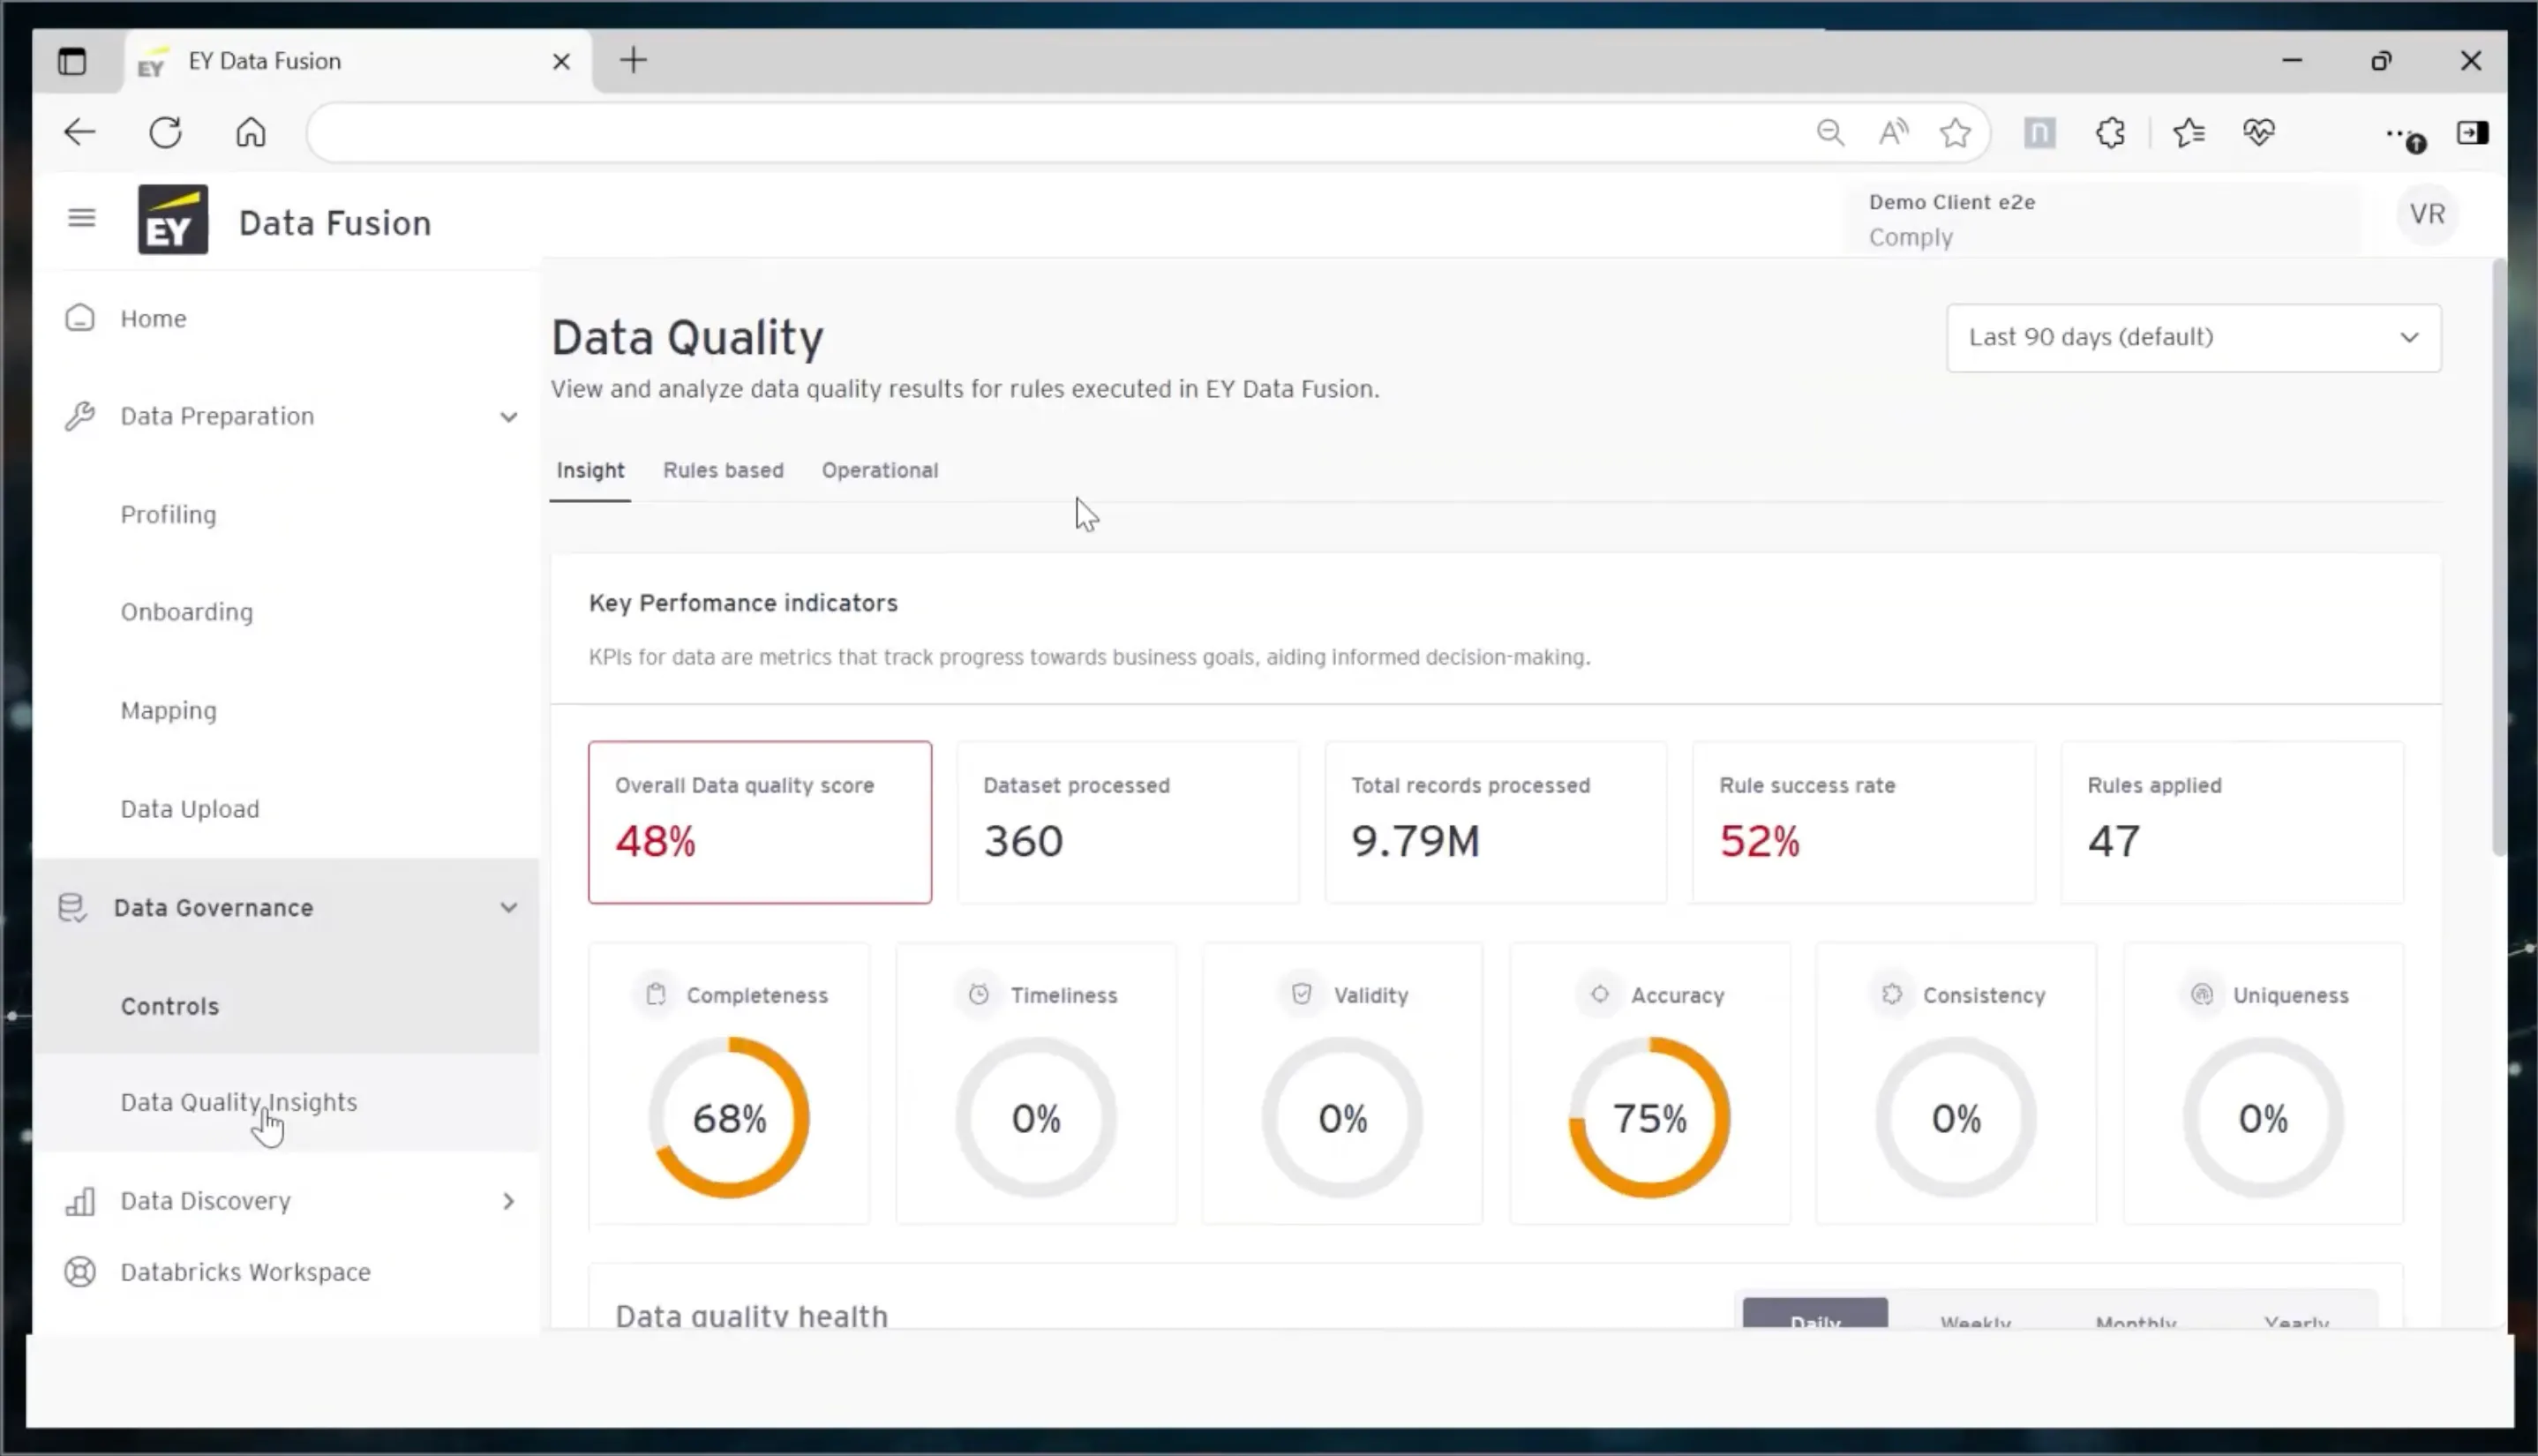
Az egyes ügyfelek szabályainak meghatározása és betartatása, az eredmények követése a Data Quality Insightsban.
- 03
Data Discovery
Nyers és rendezett adatok feltárása SQL-lekérdezésekkel a Data Explorerben.
- 04
Data Operations
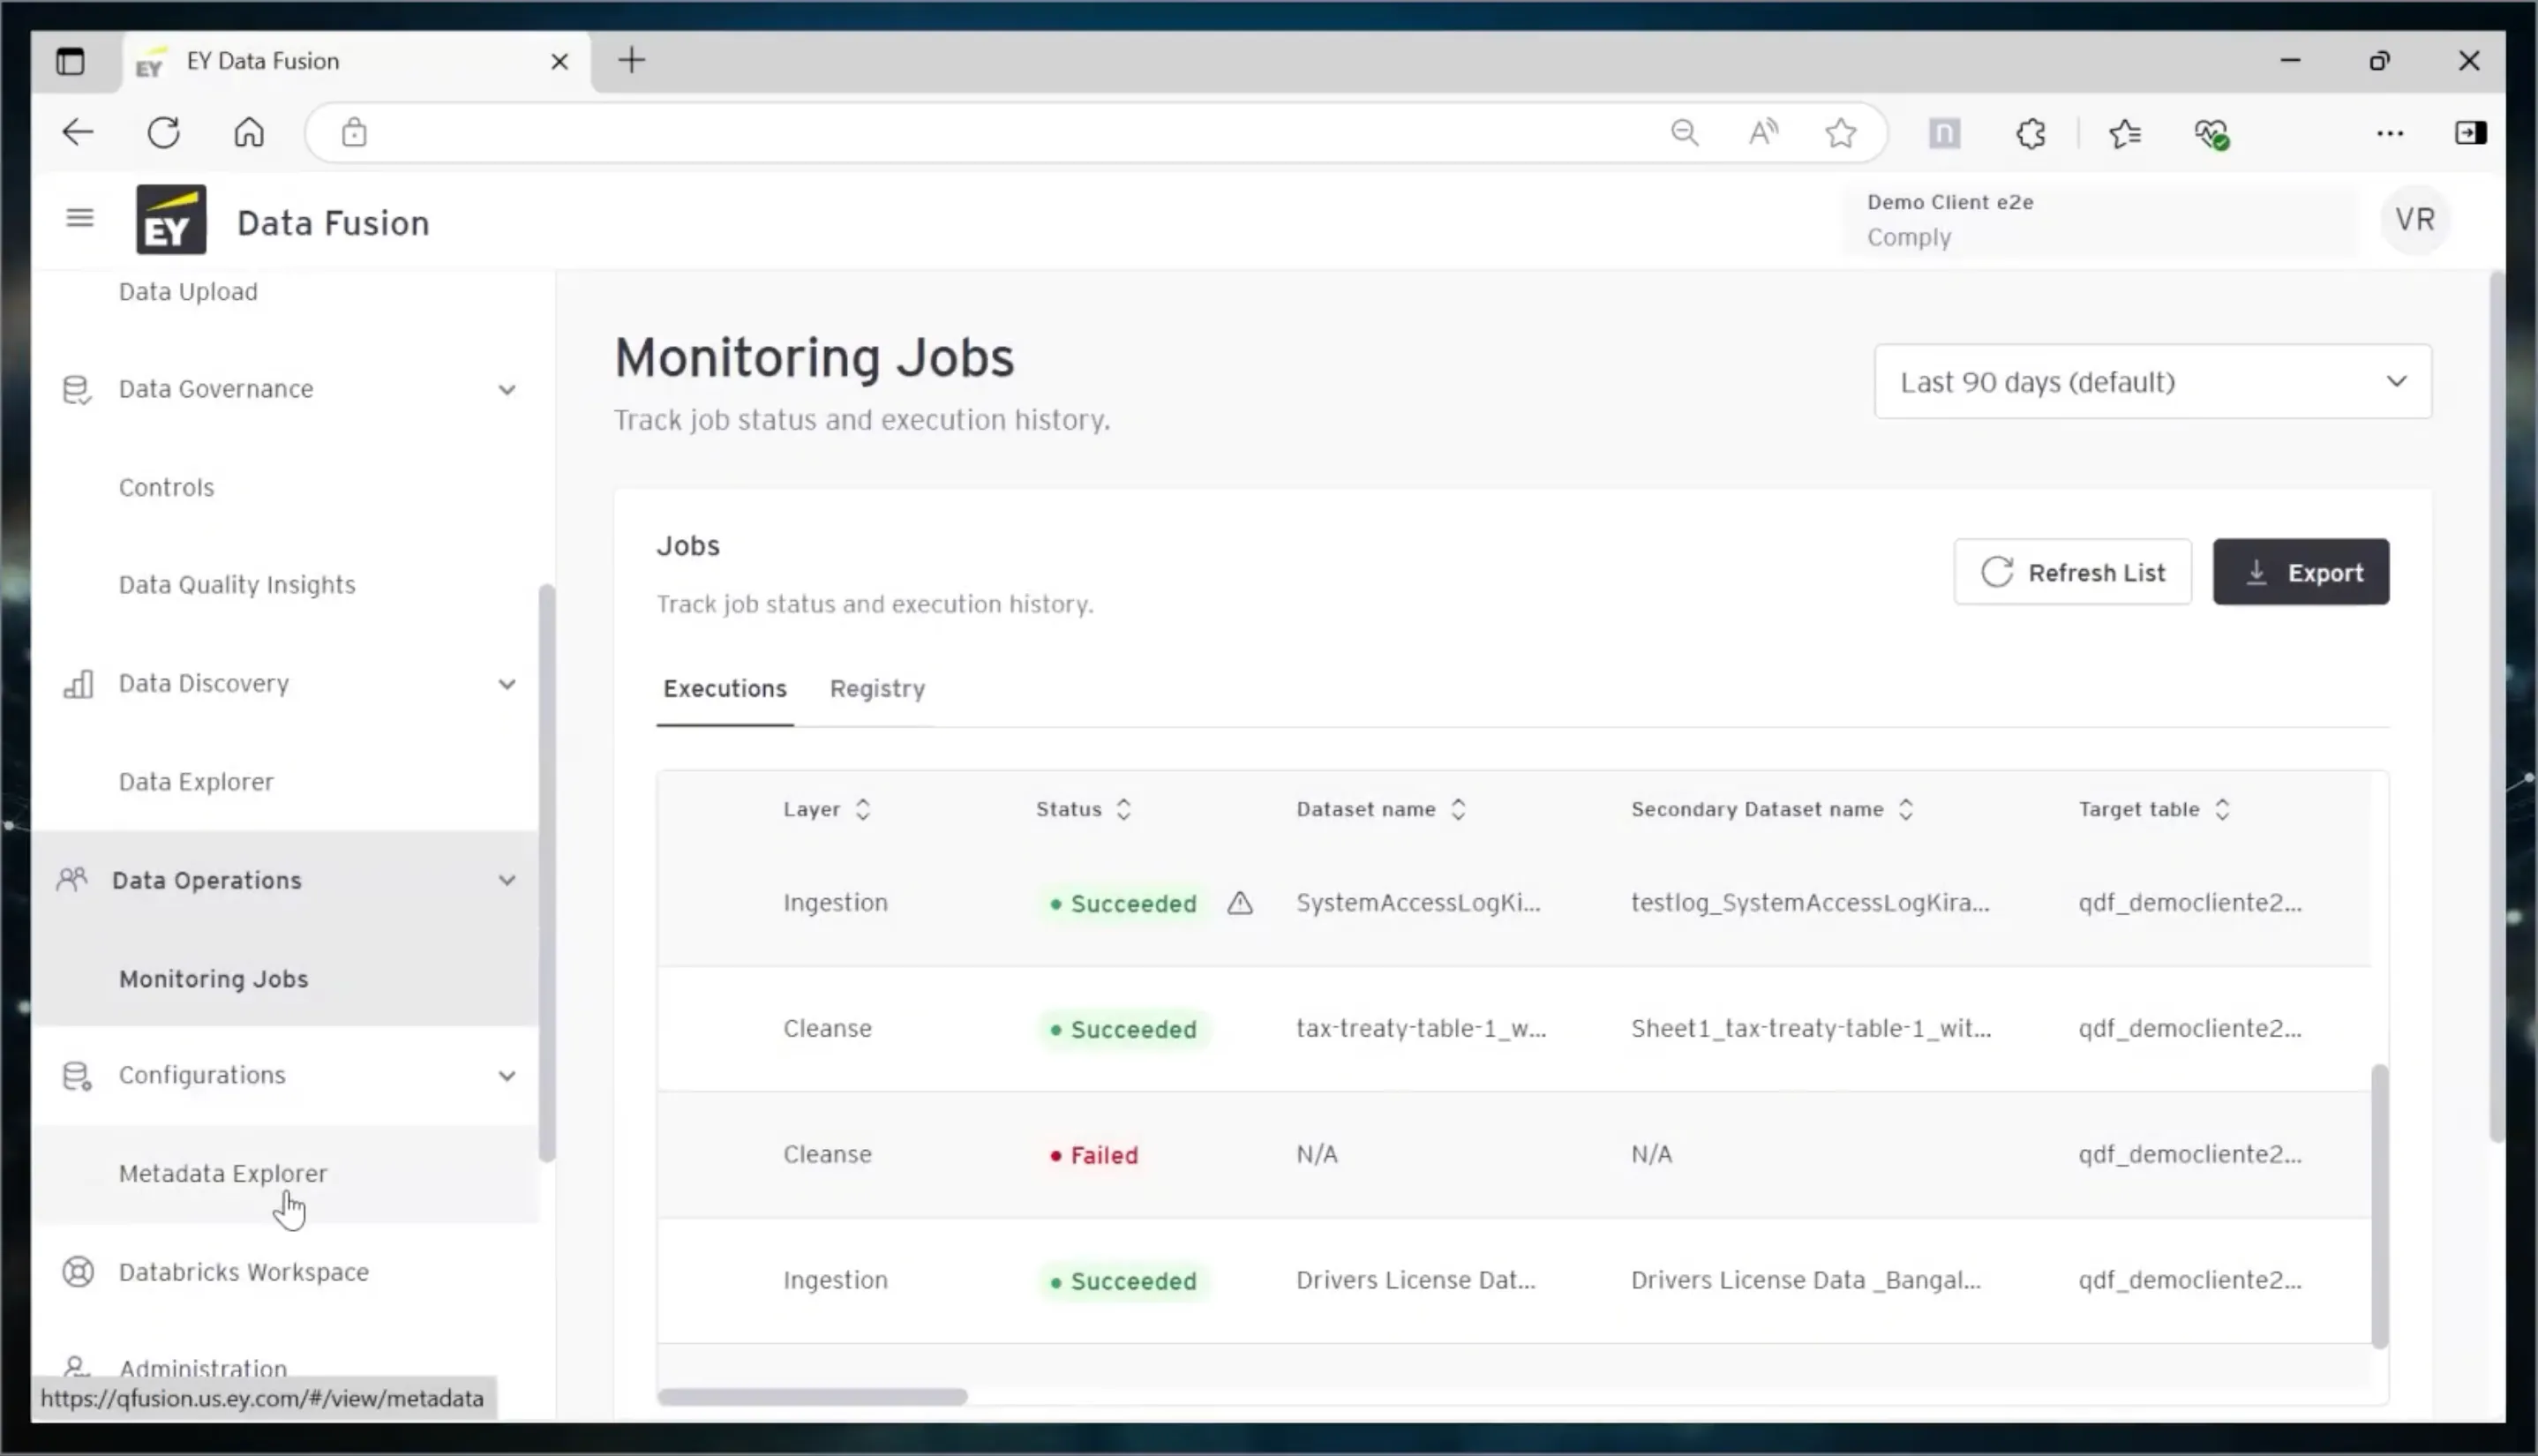
Minden adatfeladat állapotának és futási előzményeinek követése.
- 05
Configurations
A platform metaadatainak lekérdezése a Metadata Explorerrel.
- 06
App Gallery
MI- és gépi tanulási alkalmazások, amelyek bővítik a platformot, az anomáliaészleléstől az intelligens dokumentumfeldolgozásig.
MI a munkafolyamat részeként
- AI
Data Mapping Agent
Természetes nyelven megfogalmazott kérésből hoz létre vagy finomít egy adatleképezést.
- AI
Rule Agent
Automatikusan megírja egy adatminőségi szabály SQL-jét, amit a felhasználó továbbra is szerkeszthet.
- AI
Érzékeny adatok felismerése
Megtalálja a személyes és érzékeny információkat az adatokban.
- AI
MI-alapú adatminőség
Kiszűri az anomáliákat és a kiugró értékeket, mielőtt problémává válnának.
Képernyők a videóból
03 · A SZEREPEM
A platform vezető tervezője
Én hozom meg a Data Fusion tervezési döntéseit, és én is valósítom meg őket: attól, hogy egy igényt megértek a fejlesztőkkel, a folyamaton át, egészen a végleges, nagy hűségű képernyőkig, amelyek fejlesztésre kerülnek. A platform változatait is én tervezem, mint a KMS és a csatlakozó micro frontend alkalmazások.
- 01
Tervezési döntések
Meghatározom, hogyan működjön és nézzen ki minden funkció, és képviselem ezeket a döntéseket a stakeholderek és a tech leadek előtt.
- 02
Teljes körű megvalósítás
Folyamatok, wireframe-ek, prototípusok és nagy hűségű képernyők, az EY design systemjével, a Motiffal.
- 03
A bonyolultság lefordítása
Az adatmérnöki követelményeket olyan felületekké alakítom, amelyeket az üzleti felhasználók is megértenek és használnak.
- 04
Minőség az átadás után
Összevetem az elkészült munkát a tervvel, és jelzem az eltéréseket, mielőtt élesbe kerülnének.
Akikkel nap mint nap dolgozom
- Managing DirectorTermékgazda, a vízió felelőse
- 3 Tech Lead1 MI-re, 2 a termékre fókuszál
- Data EngineersPipeline-ok, szabályok, adatlogika
- Product ManagerRoadmap és prioritások
- Product OwnerKövetelmények és backlog
- Scrum MasterSprintek és ceremóniák
- FejlesztőkFrontend, backend és MI
Egy platform, több termék
Data Fusion
Az alapplatform: adatbetöltés, adatirányítás, adatminőség, adatfeltárás és üzemeltetés.
KMS Fusion
Új alkalmazás a Data Fusionre építve, amely a strukturálatlan dokumentumokat kereshető tudástárrá alakítja.
Micro frontend alkalmazások
Navigációs modell, amellyel független alkalmazások egyetlen élményként élnek a Data Fusionön belül.
04 · A KIHÍVÁS
Megtanulni az adatok nyelvét
A legnagyobb kihívás nem a felület volt, hanem a szakterület. Az adatmérnökség tele van olyan fogalmakkal, amelyek a legtöbb ember számára láthatatlanok, és nem tudtam volna jó képernyőket tervezni valamihez, amit nem értek.
Hogyan zártam be a hiányt
- 01
Sokat kérdeztem
Napi kapcsolat adatmérnökökkel és tech leadekkel. Addig kérdeztem, amíg minden fogalmat el nem tudtam magyarázni a saját szavaimmal.
- 02
Kutatás
Tanulmányoztam az ETL-t, az adatminőséget, az adatirányítást, az ontológiákat, és a strukturált és strukturálatlan adatok közti különbséget.
- 03
Leírtam
Útmutató dokumentumok és folyamatábrák a kulcsfogalmakról, a stakeholderekkel jóváhagyva. A csapatnak is referenciává váltak.
- 04
Nem szakértőknek terveztem
Mivel én is kezdő voltam, tudtam, hol túl szakmai a nyelv, és világosabb feliratokért és vezetett folyamatokért álltam ki.
Néhány szó, amit meg kellett tanulnom
- ETL
- Extract, Transform, Load. Adatot venni egy forrásból, átalakítani, és oda menteni, ahol hasznos.
- Data profiling
- Egy adatkészlet átvizsgálása a megértéséhez: szerkezet, értékeloszlás, üres mezők és kiugró értékek.
- Data mapping
- Annak meghatározása, hogy egy nyers forrás mezői hogyan lesznek egy rendezett, szabványos modell mezői.
- Data quality rule
- Ellenőrzés, amelyen az adatoknak át kell menniük, például "minden számlának van tulajdonosa". Általában SQL-ben írják.
- PII / PCI
- Személyes és bankkártyaadatok. Érzékeny adatok, amelyeket meg kell találni és védeni kell.
- Tenant
- Egy ügyfél elszigetelt tere egy sok ügyfél által megosztott platformon.
- Ontology
- Fogalmak és kapcsolataik térképe, például "a Lasagne tartalmaz Sajtot".
- Unstructured data
- Olyan információ, amely nem táblázatokban van, például PDF-ek, űrlapok és jelentések.
Az esettanulmány többi része zárolva van
Add meg a jelszót a folytatáshoz.
Hibás jelszó. Próbáld újra.